Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr

Traduction automatique
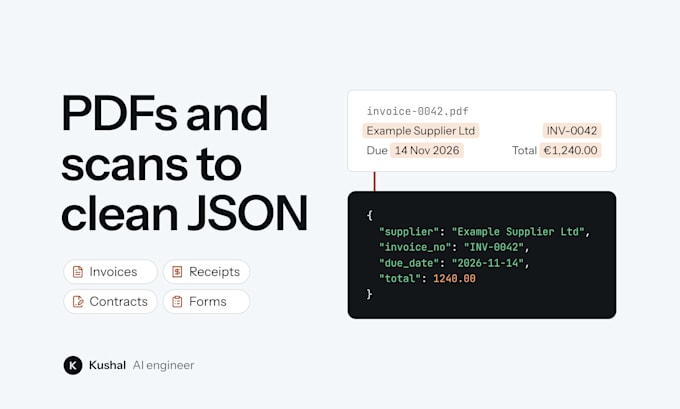
Marre de copier manuellement des données à partir de PDFs ? Je conçois des pipelines IA qui lisent des factures, des reçus, des contrats, des formulaires, des rapports et des documents scannés et les transforment en données propres et structurées.
Dans mon poste actuel, j’ai mis en place des chaînes de traitement de documents avec OCR par modèle de vision, extraction fondée sur les textes source et validation avant que quoi que ce soit n’atteigne la base de données.
CE QUE VOUS OBTIENDREZ
- Extraction des champs dont vous avez besoin vers Excel, CSV, JSON ou votre base de données
- Prise en charge des PDFs numériques ET des pages numérisées ou photographiées
- Règles de validation, avec les valeurs incertaines signalées pour révision
- Un script ou une API que vous pourrez exécuter vous-même sur de nouveaux documents
UTILISABLE POUR
- Factures, reçus et bons de commande
- Contrats et documents juridiques (parties, dates, montants, clauses)
- Formulaires, candidatures et rapports
- Relevés bancaires et documents financiers
COMMENT CELA FONCTIONNE
1. Vous partagez 10-20 documents échantillons et les champs dont vous avez besoin
2. Je mets en place l’extraction et la teste sur vos échantillons, puis je vous indique la précision
3. Vous obtenez le code, les résultats et un guide pour l’exécuter sur de nouveaux fichiers
Il y a un rapport d’extraction d’exemple dans la galerie.
Envoyez-moi d’abord un document échantillon et je vous dirai ce qui est possible.
AI Engineer: RAG chatbots, LLM apps and PDF extraction
Langues
Traduction automatique
Traduction automatique
Quelle est sa précision ?
Tout dépend de la qualité des documents. Vous obtenez un rapport de précision sur vos propres échantillons avant la livraison finale, et les valeurs incertaines sont signalées plutôt que devinées.
Cela peut-il gérer l’écriture manuelle ou les scans de mauvaise qualité ?
Les textes imprimés et les scans propres fonctionnent bien. L’écriture manuscrite et les photos de faible qualité varient, envoyez un échantillon et je vérifierai d’abord.
Combien de documents peut-il traiter ?
Les scriptes gèrent des lots de milliers de documents. L’option premium ajoute une file d’attente pour un traitement continu.
Mes données sont-elles en sécurité ?
Je l’utilise uniquement pour votre projet et je supprime ma copie après livraison. Des échantillons avec des données masquées conviennent pour les tests.
Quel est le coût d’utilisation par la suite ?
Généralement de fractions de cent à quelques centimes par page, selon le modèle. Je vous l’estimerai pour vos documents.
Quels outils utilisez-vous ?
Python, avec LlamaParse pour les PDFs numériques et un modèle de vision (GPT ou Claude) pour les scans et les photos. Chaque valeur est vérifiée par rapport au texte source avant d’être enregistrée.
Puis-je voir un exemple d'abord ?
Oui. Il existe un échantillon de rapport d’extraction dans la galerie, et vous pouvez m’envoyer l’un de vos documents avant de passer commande.