Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Transformer les données en solutions avec précision
Besoin d’un ingénieur des données pour vos pipelines ETL ? DAG Airflow qui échoue ? Job Spark qui manque de mémoire ? Je répare rapidement les pipelines de données défectueux, puis je m’assure qu’ils ne tombent plus en panne.
Marre des échecs de DAG à 2 heures du matin ? J’ajoute un agent IA à votre pile Airflow + Spark qui diagnostique les pannes, corrige automatiquement les pannes simples, et vous envoie un rapport clair sur la cause principale pour les autres.
Ce que vous obtenez :
La pile technologique : Airflow, Spark, Kafka, NiFi, HDFS, MinIO, Agentic Frameworks.

Traduction automatique
En quoi l'Agentic ETL diffère-t-il de l'ETL traditionnel ?
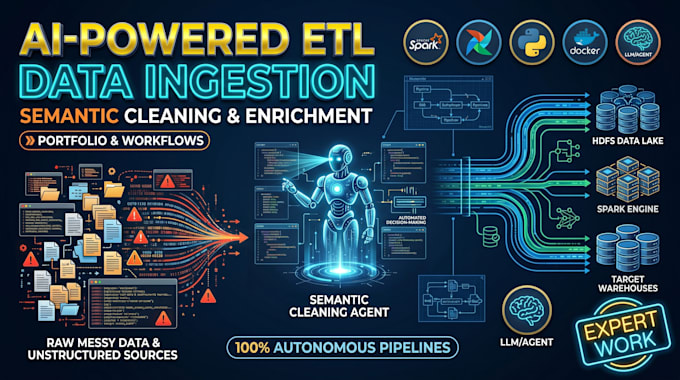
L'ETL traditionnel repose sur des règles rigides et codées en dur qui échouent lorsque les formats de données changent. Mes pipelines ETL agentiques utilisent l'IA pour comprendre sémantiquement, analyser et nettoyer des données non structurées ou désordonnées avant de les intégrer en toute sécurité dans votre data lake HDFS, rendant le pipeline très résilient.
Mes données d'entreprise sont-elles sécurisées avec ces agents IA ?
Bien que nous puissions intégrer des API commerciales, je me spécialise dans le déploiement de LLMs sécurisés et locaux (comme Qwen, DeepSeek, ou des agents basés sur des frameworks) directement dans votre environnement conteneurisé. Cela garantit que vos données sensibles ne quittent jamais votre réseau interne ou votre cluster.
Dois-je migrer depuis mon infrastructure actuelle ?
Non. Je conçois ces workflows agentiques pour s'intégrer parfaitement à vos configurations Apache Airflow et Spark existantes. Je package tout avec Docker (ou Docker Swarm pour une haute disponibilité) afin que cela s'intègre directement à votre architecture actuelle.
Que se passe-t-il si l'agent ne peut pas résoudre une panne ?
Le problème est escaladé. Vous recevez une alerte Slack ou par email avec la cause principale, les lignes de journal pertinentes et une solution proposée. Les modifications risquées (code, schéma, tout ce qui touche aux données de production) nécessitent toujours votre approbation. L'agent ne corrige automatiquement que les types de panne que nous avons convenus comme sûrs.
Pouvez-vous concevoir un nouveau pipeline ETL from scratch, et pas seulement en réparer un ?
Oui. je conçois et construis des pipelines de données de bout en bout : ingestion depuis des API, des bases de données ou des fichiers, transformation en PySpark ou Python, orchestration avec Apache Airflow, et chargement dans PostgreSQL, S3, Hive ou votre data warehouse.