Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur en automatisation et intelligence artificielle
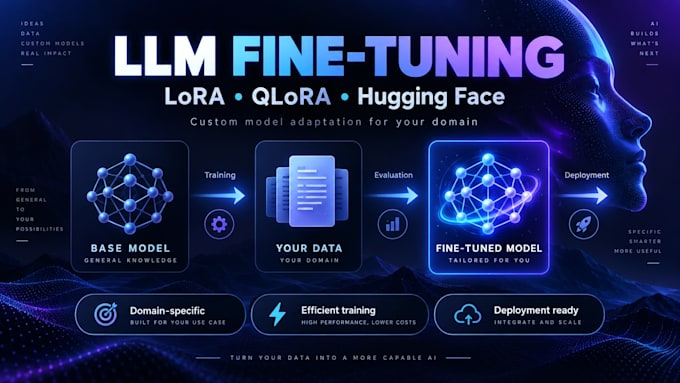
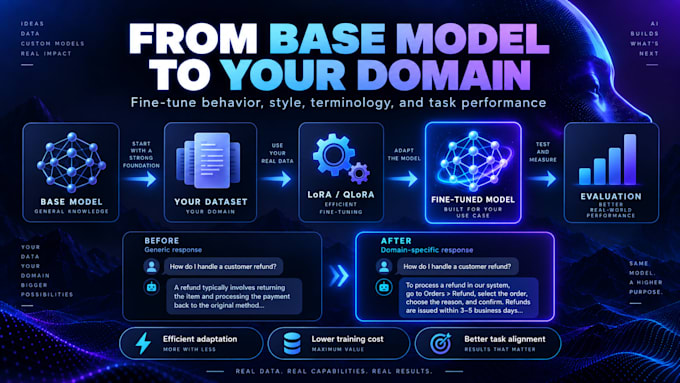
Vous avez besoin d’un LLM qui comprend mieux votre domaine, votre terminologie, votre style d’écriture, votre tâche ou votre jeu de données propriétaire que le modèle de base ?
Je vais affiner un modèle de langage large open-source en utilisant des techniques modernes et efficaces en termes de paramètres comme LoRA et QLoRA, en exploitant l’écosystème Hugging Face.
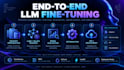
Plutôt que de simplement exécuter un script d’entraînement, je me concentre sur le processus complet de fine-tuning :
Jeu de données -> Entraînement -> Évaluation -> Inférence -> Déploiement
Je peux vous aider avec :
Je peux travailler avec des modèles open-source adaptés issus de l’écosystème Hugging Face, notamment la famille Llama, Qwen, Mistral, Gemma, et d’autres modèles de langage basés sur des transformers.

Fortinet
Cybersecurity
I worked with Sken.ai, now acquired by Fortinet, on a short-term project, conducting machine learning experiments on proprietary data. Using AWS, I focused on finding patterns, clustering, and classification within textual data.
avr. 2021-avr. 2021
Traduction automatique
Qu'est-ce que LoRA ?
LoRA est une technique de fine-tuning efficace en termes de paramètres qui adapte un grand modèle de langage en entraînant un nombre relativement faible de paramètres supplémentaires au lieu de mettre à jour l'ensemble du modèle. Cela réduit considérablement la mémoire GPU et les besoins en formation.
Qu'est-ce que QLoRA ?
QLoRA combine la quantification avec LoRA afin que de grands modèles puissent être ajustés avec beaucoup moins de mémoire GPU tout en conservant une grande partie de leur capacité d'origine. Il est particulièrement utile lorsque les ressources de calcul sont limitées.
Pouvez-vous ajuster n'importe quel modèle Hugging Face ?
Je peux travailler avec de nombreux modèles basés sur des transformers qui supportent un fine-tuning pratique via l'écosystème Hugging Face. Veuillez m'envoyer le modèle exact ou vos exigences avant de commander, car le matériel, l'architecture, la licence et la taille du dataset peuvent influencer la faisabilité.
Pouvez-vous ajuster les modèles Llama, Qwen, Mistral ou Gemma ?
Oui, lorsque le modèle choisi, le matériel, la licence et les exigences du projet le permettent. Je recommanderai la taille du modèle et la stratégie de fine-tuning en fonction de votre tâche et des ressources disponibles.
Ai-je besoin d’un ensemble de données ?
Oui. Le fine-tuning nécessite des données d'entraînement adaptées. Si votre dataset nécessite une légère restructuration ou mise en forme, cela peut être inclus selon le package.
De combien de données ai-je besoin ?
Cela dépend de la tâche et de la qualité des exemples. Un petit dataset de haute qualité peut parfois surpasser un dataset beaucoup plus grand mais bruyant. J'évaluerai le dataset avant l'entraînement et recommanderai s'il est adapté.
Pouvez-vous garantir que le modèle ajusté sera meilleur ?
Aucun ingénieur en IA responsable ne devrait garantir cela avant les tests. La performance dépend du modèle de base, de la qualité du dataset, de la taille du dataset, de la configuration d'entraînement, de la méthode d'évaluation et de la tâche cible. C'est pourquoi l'évaluation fait partie de mon processus de travail.
Dois-je utiliser RAG ou le fine-tuning ?
Ils résolvent des problèmes différents. RAG est généralement approprié lorsque le modèle doit accéder à des connaissances changeantes ou privées. Le fine-tuning est utile lorsque vous souhaitez modifier le comportement du modèle, l'adaptation à un domaine, le style, la terminologie, le format de sortie ou la performance de la tâche. Certaines systèmes bénéficient des deux.
Pouvez-vous déployer le modèle ajusté ?
Oui. Le package Premium peut inclure une API d'inférence, une configuration Docker, une documentation de déploiement et des conseils d'intégration. Les coûts d'infrastructure cloud et d'hébergement GPU sont séparés.
Qui paie pour la formation GPU/cloud ?
Tous les coûts importants liés à des GPU tiers, API, stockage ou hébergement sont à la charge du client, sauf si cela est explicitement inclus dans l'offre personnalisée. Je discuterai des besoins en calculs attendus avant l'entraînement.
| (2) | ||
| (0) | ||
| (0) | ||
| (0) | ||
| (0) |
jo1hnj

États-Unis
Suggested a creative solution to the problem. Delivery time was great. Clear documentation so the results are reproducible.
100 $US-200 $US
Prix
4 jours
Durée
kr1s_ra

Autriche
Pleasure doing business. Very fast delivery.
50 $US
Prix
3 jours
Durée
| (2) | ||
| (0) | ||
| (0) | ||
| (0) | ||
| (0) |
jo1hnj
États-Unis
Suggested a creative solution to the problem. Delivery time was great. Clear documentation so the results are reproducible.
100 $US-200 $US
Prix
4 jours
Durée
kr1s_ra
Autriche
Pleasure doing business. Very fast delivery.
50 $US
Prix
3 jours
Durée