Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD

Level 1
Traduction automatique
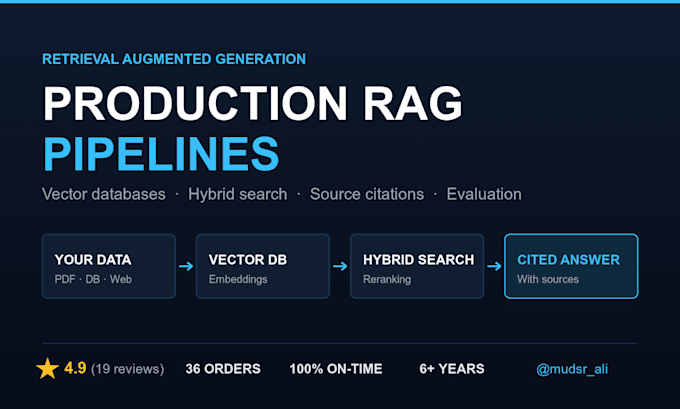
Vous avez besoin d’un chatbot RAG ou d’un pipeline de récupération qui fasse plus que simplement envoyer des documents à un LLM ?
Je crée des systèmes de génération augmentée par récupération (RAG) sur mesure qui extraient des informations pertinentes de vos données et les utilisent pour générer des réponses contextuelles.
Ce que je peux réaliser :
Stack technologique : Python, FastAPI, LangChain ou LlamaIndex selon le besoin, PostgreSQL/pgvector, Qdrant, Chroma et autres stockages vectoriels compatibles.
Je peux vous aider à construire un nouveau pipeline RAG, améliorer une implémentation existante ou intégrer la récupération dans votre application.
Chaque projet a des données, des exigences de qualité et des contraintes d’infrastructure différentes. Merci de m’envoyer un message avec votre cas d’usage, vos sources de données et le résultat attendu avant de commander, afin que nous puissions définir ensemble le bon périmètre.
Senior Software Engineer, SaaS, Backend, Cloud, Ai
Level 1
Langues
Traduction automatique
Traduction automatique
Quel package correspond à mon projet ?
Dites-moi approximativement combien de contenu vous avez et où il se trouve. La formule starter convient à une seule source de moins de 500 pages. La formule production convient à un corpus complet où la précision des réponses est importante. La plateforme convient à plusieurs systèmes en constante évolution.
Quelle base de données vectorielle utilisez-vous ?
Selon votre cas : Pinecone, Qdrant, Weaviate, Chroma ou pgvector. Si vous utilisez déjà PostgreSQL, pgvector évite souvent un nouveau service et un coût supplémentaire. Je recommande en fonction de l’échelle et du budget, pas de préférence.
Quelle sera la précision des réponses ?
Je ne promets pas un chiffre avant d’avoir vu vos données. Ce que je garantis, c’est la mesure : la formule Standard et Premium inclut une suite d’évaluation pour voir la précision de la récupération, et chaque réponse comporte des citations pour que les erreurs soient traçables.
Qui paie pour l'utilisation de l'API OpenAI ou Claude ?
Vous gérez cela vous-même, avec vos comptes, pour garder le contrôle et la visibilité totale sur les dépenses. Les coûts d’intégration et de requête sont les deux principaux facteurs. J’estime votre coût mensuel réaliste avant de commencer et j’intègre la mise en cache et les limites de tokens pour le réduire.
Mes données restent-elles privées ?
Tout fonctionne sur votre infrastructure et vos comptes de fournisseur. J’utilise des API qui ne s’entraînent pas sur vos données, et je signerai un NDA. Si vos documents ne peuvent pas quitter vos serveurs, je peux construire une solution entièrement auto-hébergée avec des modèles open source.
De quoi avez-vous besoin de ma part pour commencer ?
Un échantillon de vos documents ou accès à votre base de données, 10 à 20 questions exemples que les utilisateurs poseront, et votre clé API de fournisseur. Les questions exemples sont les plus importantes : elles deviennent l’ensemble d’évaluation contre lequel j’ajuste la récupération.
