Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Scientifique des données
Vous recherchez un data scientist expérimenté pour transformer des données brutes et désorganisées en
insights exploitables et modèles prédictifs précis ? Vous êtes au bon endroit.
Je suis un data scientist professionnel, expert en Python, R et IBM
SPSS. Je fournis du code propre et prêt pour la production, ainsi que des insights à fort impact.
Ce que je propose : Nettoyage des données : gestion des valeurs manquantes, des valeurs aberrantes, des duplications,
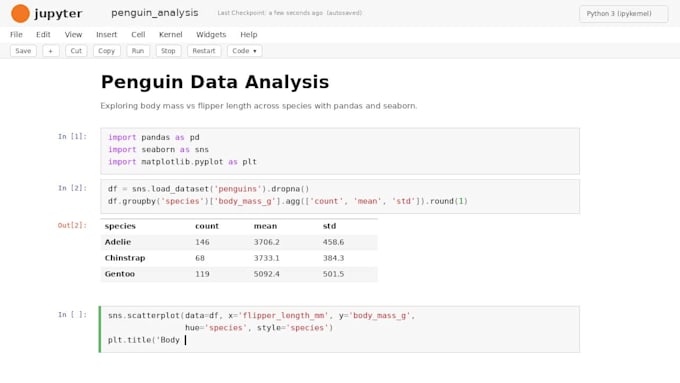
et ingénierie des caractéristiques. EDA et visualisation : analyse exploratoire approfondie,
identification des tendances et graphiques clairs (Matplotlib, Seaborn, ggplot2).
Modélisation statistique (SPSS et R) : tests d'hypothèses (t-tests, ANOVA,
Chi-square), régression et analyse des données d'enquête. Machine Learning
(Python/R) : classification, régression, clustering (Random Forest, XGBoost,
LightGBM, SVM) et ajustement des modèles.
Outils et technologies : Python | R et RStudio | IBM SPSS | Jupyter Notebook |
Pandas | NumPy | Scikit-Learn
Pourquoi me choisir ?
- Code propre, commenté et reproductible
- Rapports visuels clairs expliquant les chiffres
- Livraison rapide et satisfaction à 100 % garantie
Veuillez m’envoyer un message avant de passer commande pour discuter de vos besoins et
de la portée du projet !


Traduction automatique
Fournirez-vous le code source ?
Oui, absolument. Vous recevrez un code source entièrement documenté, lisible et reproductible (Jupyter Notebook .ipynb, R Markdown ou script propre).
Mes données sont confidentielles. Pouvez-vous signer un NDA ?
Oui. Je traite toutes les données des clients avec une confidentialité stricte. Si nécessaire, je peux signer un accord de confidentialité (NDA).
Pouvez-vous travailler avec des données académiques ou d’enquête utilisant SPSS ?
Oui. J'ai une vaste expérience dans la réalisation de tests statistiques (t-tests, ANOVA, Chi-carré, analyse de fiabilité) et l'interprétation des résultats au format APA en utilisant IBM SPSS et R.
Et si je ne sais pas quel modèle de Machine Learning est le mieux adapté à mon problème ?
Aucun problème ! Partagez simplement votre ensemble de données et votre objectif métier. J'essayerai plusieurs algorithmes à l'état de l'art et recommanderai celui qui offre la meilleure précision et la meilleure généralisation.