Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD

Traduction automatique
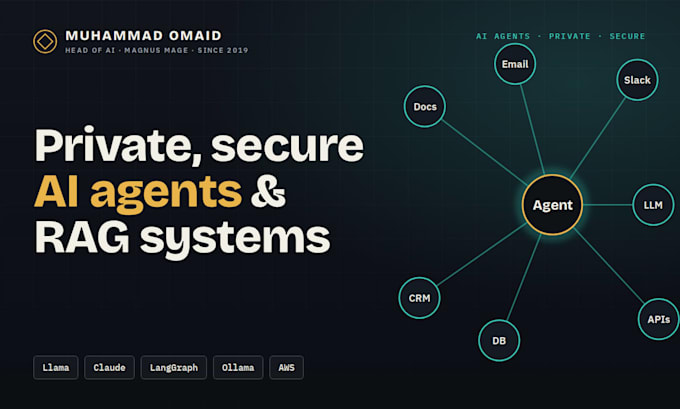
Vous avez besoin d'une IA qui fonctionne sur votre propre infrastructure, avec vos données qui ne quittent jamais cet environnement, et des garde-fous qu'une équipe de sécurité validera ?
Je suis Muhammad Omaid, responsable de l'IA chez Magnus Mage (créé en 2019), plus de 8 ans dans le développement logiciel, entouré de plus de 10 ingénieurs. Quatre systèmes d'IA en production : un agent de sécurité sur appareil, l'automatisation des vulnérabilités Bugshot, la couche IA de Xyress et une plateforme CRM multi-tenant basée sur l'IA.
Ce que nous construisons :
RAG et agents sur vos documents, bases de données et API : embeddings personnalisés, FAISS ou pgvector, récupération rapide avec encodage et décodage optimisés.
Services FastAPI depuis zéro avec schemas Pydantic, empaquetés dans des conteneurs Docker conçus pour un trafic important.
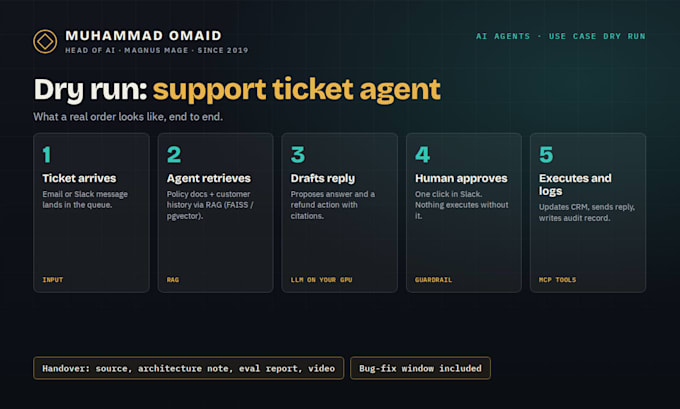
Agents multi-outils avec approbation humaine avant actions privilégiées, outils à privilège minimal et journalisation des audits.
Inférence privée : modèles ouverts sur vos GPUs via Ollama ou vLLM ; fine-tuning QLoRA lorsque les prompts ne suffisent pas.
Déploiement sur AWS, Kubernetes ou sur site avec surveillance et évaluations ; montée en charge sur devis personnalisé.
Ce que vous obtenez : code source, note d'architecture, rapport d'évaluation, vidéo de présentation et fenêtre de correction de bugs.
Pas de bots de trading, pas de résultats garantis. Contactez-nous avant de commander avec votre cas d'utilisation, vos données et votre hébergement pour un devis personnalisé.
Head of AI at Magnus Mage, LLM RAG and fine tuned models
Langues
Traduction automatique
Traduction automatique
Tout peut-il fonctionner sur site ou dans mon VPC ?
Oui. Notre configuration par défaut utilise des modèles ouverts (Llama, Qwen, Mistral) servis sur vos GPUs ou dans votre cloud, avec vos données qui restent dans votre environnement. Les API hébergées (OpenAI, Claude) ne sont utilisées que si vous les choisissez.
Quels contrôles de sécurité intégrez-vous ?
Approbation humaine avant les actions modifiant l'état, scoping des outils à privilège minimal, contexte du modèle uniquement par métadonnées (pas de secrets ni corps de requête), journaux d'audit en mode append-only, tests d'injection de prompts. Aligné avec les recommandations OWASP sur les requêtes.
Faites-vous du fine-tuning ou utilisez-vous uniquement des prompts ?
Les deux. Prompting et RAG en premier ; lorsque cela ne suffit pas, nous effectuons un fine-tuning QLoRA sur vos données (nos exécutions ont réduit la perte d'entraînement d'environ 95 %). Le fine-tuning est inclus dans Premium ou disponible en service séparé.
Que se passe-t-il si quelque chose se casse après la livraison ?
Chaque package inclut une fenêtre de correction de bugs pour le périmètre livré : 7 jours Basic, 14 jours Standard, 30 jours Premium. La maintenance continue est disponible en option ou en contrat de rétention.
Acceptez-vous des projets plus importants ou à long terme ?
Oui. La majorité de nos travaux s'étalent sur plusieurs mois. Contactez-nous avec le périmètre et nous vous enverrons une offre personnalisée avec des étapes clés.
Pouvez-vous signer un NDA ?
Oui. Envoyez-le via la messagerie Fiverr avant de commander et nous le renverrons signé.