Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD

Traduction automatique
Vous avez besoin d’un système d’IA personnalisé, pas simplement une enveloppe autour d’une API ? Je le planifie, le construis à partir de zéro, et vous remets le code.
Muhammad Omaid, responsable de l’IA chez Magnus Mage (créé en 2019) : plus de 8 ans en production, plus de 10 ingénieurs, 4 systèmes d’IA en ligne.
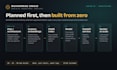
Les 5 à 10 premiers jours sont consacrés à la planification : architecture, sélection des bibliothèques, rédaction d’un plan que vous approuvez avant le développement.
Ce que nous construisons à partir de zéro :
RAG : embeddings personnalisés, encodage et décodage ajustés, FAISS ou pgvector, récupération regroupée en 3D pour optimiser le découpage et la recall.
Post-formation : SFT, DPO, QLoRA sur Llama, Qwen ou Mistral, avec rapports d’évaluation ; inférence privée sur vos GPU.
Multi-LLM : routage entre modèles ouverts et hébergés selon le coût, la latence et la sensibilité des données.
Services FastAPI avec schémas Pydantic, workers asynchrones et contrats OpenAPI.
Conteneurs Docker pour entreprise, adaptés à un trafic élevé : testés en charge, surveillés, sur AWS, Kubernetes ou en local.
Sécurité : authentification, limites de débit, journal d’audit.
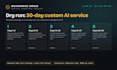
Forfaits : MVP en 30 jours, avancé en 45 ; entreprise avec une équipe dédiée à 10 000 $ par mois.
Vous recevez le code source, le document d’architecture, les rapports de test en charge et d’évaluation, CI/CD, vidéo de présentation, fenêtre de correction de bugs.
Contactez-nous avant de commander avec votre cas d’usage, vos données et votre trafic pour un devis personnalisé.
Head of AI at Magnus Mage, LLM RAG and fine tuned models
Langues
Traduction automatique
Traduction automatique
Que se passe-t-il lors de la phase de planification ?
Jours 1 à 5 (MVP) ou 1 à 10 (Avancé) : nous cartographions votre cas d’usage, vos données et votre trafic, choisissons l’architecture et les bibliothèques (FastAPI, FAISS ou pgvector, Transformers, Docker, Kubernetes) et rédigeons un plan avec des jalons. Vous l’approuvez avant tout développement.
Que signifie RAG construit à partir de zéro ?
Pas de modèles préfabriqués. Nous entraînons ou ajustons des embeddings personnalisés, optimisons l’encodage et le décodage pour vos documents, indexons dans FAISS ou pgvector, et regroupons l’espace de récupération en 3D pour ajuster la taille des chunks et la recall. Vous obtenez des métriques de récupération, pas seulement un chatbot.
Qu’est-ce que la post-formation et quand en ai-je besoin ?
La post-formation adapte un modèle ouvert (Llama, Qwen, Mistral) à vos données avec SFT, DPO ou QLoRA. Vous en avez besoin lorsque les prompts et RAG ne suffisent pas : langage spécifique au domaine, formats de sortie stricts, appel d’outils. Incluse dans Avancé et Entreprise, avec rapport d’évaluation avant et après.
Qu’est-ce que le routage multi-LLM ?
Une API, plusieurs modèles. Les requêtes sont routées selon le coût, la latence et la sensibilité des données : les données sensibles restent sur votre modèle privé, les tâches générales vont vers un modèle hébergé, avec sauvegardes et suivi du coût par appel. Inclus dans Avancé et Entreprise.
Pourquoi FastAPI et Pydantic ?
FastAPI offre des services asynchrones à haut débit avec contrats OpenAPI intégrés ; Pydantic valide chaque requête et réponse pour que la couche LLM ne reçoive ni ne renvoie jamais de données mal formées. Les deux sont écrits à partir de zéro pour votre système, sans générateurs de boilerplate.
Comment gérez-vous un trafic important ?
Conteneurs Docker d’entreprise avec workers asynchrones et queues, scaling horizontal sur Kubernetes ou AWS, mise en cache, limites de débit et test de charge à votre trafic cible avant la livraison. La surveillance et les alertes sont incluses dans Avancé et Entreprise.
Peut-il fonctionner sur votre propre infrastructure ?
Oui. Tout est déployé en conteneurs Docker et fonctionne sur votre cloud (AWS, GCP, Azure), Kubernetes ou en local avec GPU. Pour l’inférence privée, nous servons des modèles ouverts avec vLLM ou Ollama, pour que vos données ne quittent jamais votre réseau.
MVP, Avancé ou Entreprise : lequel choisir ?
MVP (30 jours) : un service d’IA avec RAG, FastAPI et Docker. Avancé (45 jours) : MVP plus un modèle post-entrainé, routage multi-LLM, clustering de récupération 3D et surveillance. Entreprise : une équipe dédiée à 10 000 $ par mois, minimum deux mois, renouvelable selon vos besoins.
Qu'est-ce que je reçois à la fin ?
Code source dans votre dépôt, document d’architecture, rapports de test en charge et d’évaluation, pipeline CI/CD, images Docker, vidéo de présentation et fenêtre de correction de bugs. Vous possédez le code, les poids du modèle et les données.
Comment travaillons-nous ensemble ?
Contactez-nous avant de commander avec votre cas d’usage, vos données et votre trafic ; nous vous répondrons avec un plan et un devis personnalisé. Pendant la réalisation : mises à jour quotidiennes sur Fiverr, jalons, démo à la fin de chaque phase. NDA sur demande.


