Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD



Traduction automatique
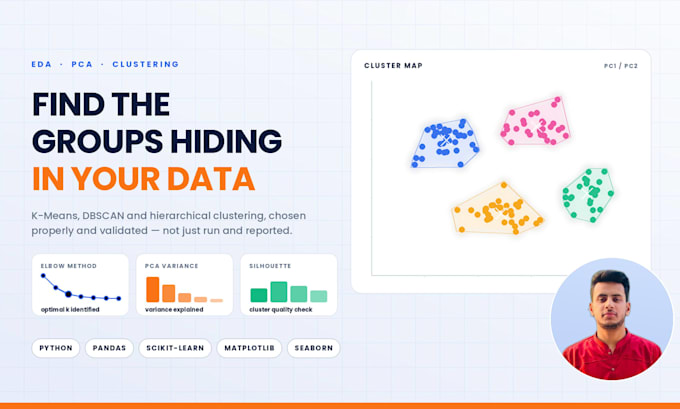
Vous avez des données que vous ne pouvez pas lire ? Vous ne savez pas quels clients cibler, lesquels sont sur le point de partir ou ce qui influence vos chiffres ?
Je suis là pour ça.
Envoyez-moi votre jeu de données et je repérerai les motifs qui s’y cachent, puis je vous expliquerai ce qu’ils signifient pour votre entreprise en langage simple, sans jargon.
Comment je procède
Ce que cela change pour vous
Je vous dirai honnêtement ce que vos données peuvent ou ne peuvent pas répondre avant que vous dépensiez un centime.
Contactez-moi avec votre jeu de données et votre objectif. Je l’examinerai et vous recommanderai la meilleure approche.
Data Scientist and Full Stack Developer
Langues
Traduction automatique
Traduction automatique
De quelles données avez-vous besoin pour commencer ?
Vous pouvez fournir votre dataset en format CSV, Excel ou JSON. Si vos données sont brutes, je peux également gérer le prétraitement.
Quels algorithmes de clustering utilisez-vous ?
J’utilise K-Means, le clustering hiérarchique et DBSCAN. Je choisis la meilleure méthode en fonction de votre dataset et de vos objectifs.
Réalisez-vous aussi une réduction de dimension ?
Oui, j’offre PCA pour réduire les dimensions, visualiser les clusters et améliorer la performance.
Pouvez-vous aussi construire des modèles de classification ?
Absolument. Je peux construire et évaluer des modèles KNN et SVM selon vos besoins.
Obtiendrai-je des visualisations ?
Oui — graphiques de clusters, visualisations PCA, heatmaps de corrélation, pairplots, et plus (selon votre package).
Pouvez-vous travailler avec des données désordonnées ou incomplètes ?
Oui, je gère les valeurs manquantes, les outliers, l’encodage, la mise à l’échelle et le prétraitement complet.
Vous expliquerez les résultats ?
Bien sûr. Je fournis des insights clairs, des interprétations et des recommandations basés sur les résultats.
Fournissez-vous le code ?
Oui, vous recevrez un code Python propre, organisé et commenté (Jupyter Notebook ou fichier .py).
Pouvez-vous m’aider à choisir le bon algorithme ?
Oui — indiquez votre objectif, et je vous guiderai vers la meilleure approche de clustering ou de classification.
Comment garantissez-vous la confidentialité et la sécurité des données ?
Vos données sont traitées avec une confidentialité stricte. Je ne partage, ne réutilise ni ne stocke jamais vos fichiers au-delà du projet. Tout reste sécurisé et est supprimé immédiatement après la livraison sur demande.