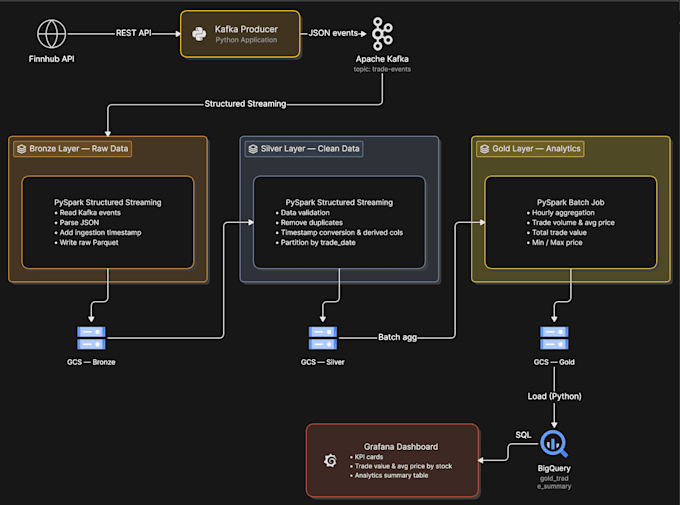
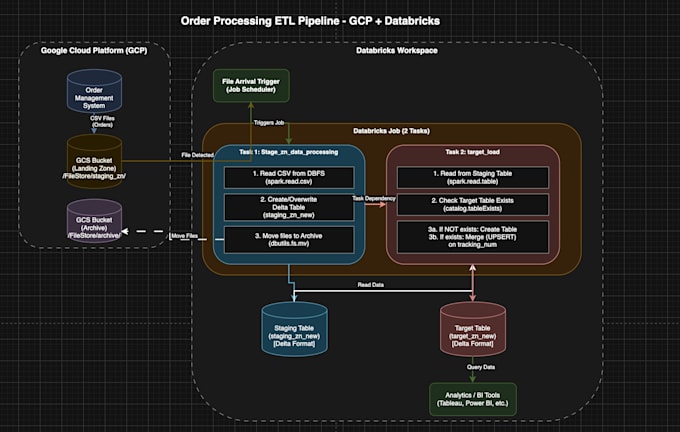
Imaginez disposer d’un pipeline de données qui extrait sans effort les données de sources multiples, les nettoie et les transforme, et fournit des données fiables prêtes à l’analyse. C’est là que je peux vous aider ! Fort d’une expérience pratique en data engineering chez Airtel Digital et Grant Thornton Bharat, je peux vous aider à concevoir des pipelines de données efficaces, optimiser le traitement des données et automatiser des flux de travail adaptés à vos besoins métier.
Mes compétences :
- Maîtrise avancée de Python, SQL, PySpark et Spark SQL
- Expérience avec Apache Spark, Databricks et Delta Lake
- Expérience pratique avec Apache Kafka et le streaming de données en temps réel
- Expérience dans la construction de pipelines ETL, chargements incrémentiels et cadres de déduplication des données
- Connaissance de Google Cloud Platform, Google Cloud Storage et BigQuery
- Expérience en optimisation des performances de Spark et en optimisation des requêtes SQL
- Compréhension de l’entreposage de données, de la modélisation et de la qualité des données
- Forte capacité de résolution de problèmes et d’analyse
Ce que je fais :
- Data Engineering : Conception et optimisation de pipelines ETL à l’aide de Python, SQL et PySpark.
- Nettoyage et transformation des données : Nettoyer, valider et transformer les données brutes en jeux de données structurés et prêts à l’analyse.
- Automatisation des pipelines : Automatiser les traitements répétitifs des données