Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Développeur Web Full Stack en Data Science, Économétrie spatiale, Intégration IA
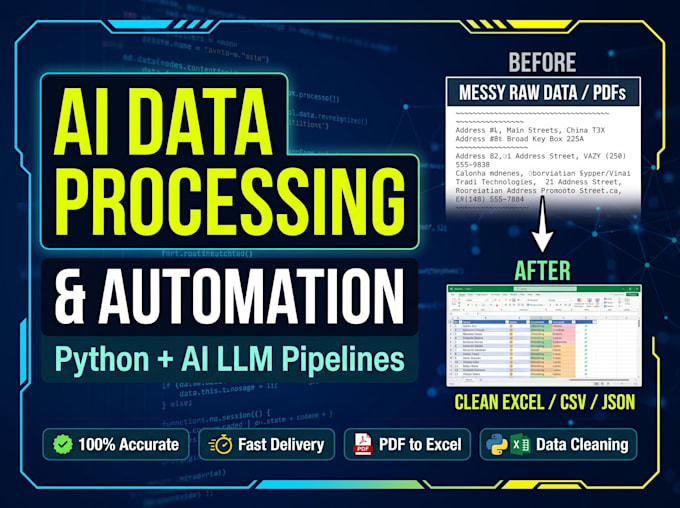
Noyé dans des feuilles de calcul désorganisées, des avis clients peu structurés ou des centaines de PDFs non structurés ?
L’entrée manuelle des données est lente et sujet à erreurs, tandis que des scripts basiques échouent sur des textes incohérents. Je combine l’automatisation en Python avec des pipelines IA de haute précision pour transformer vos données brutes en fichiers Excel, CSV ou JSON propres et prêts à l’analyse.
Ce que je peux faire pour vos données :
Pourquoi travailler avec moi ?
Envoyez-moi un échantillon (10–20 lignes ou 1 page PDF) avant la commande pour un test gratuit !


Technologie:
Excel
•
Google Sheets
•
Python
Traduction automatique
Quels formats de fichiers acceptez-vous et livrez-vous ?
J’accepte les CSV, Excel (.xlsx), JSON, TXT et PDFs basés sur du texte. Je livre des fichiers CSV, Excel ou JSON propres et structurés, prêts à l’emploi.
Pouvez-vous traiter des PDFs scannés ou basés sur des images ?
Oui, je peux appliquer un prétraitement OCR avant d’exécuter le pipeline d’extraction IA. Veuillez me contacter d’abord avec une page échantillon afin que je puisse confirmer la lisibilité.