Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Ingénieur IA : agents LLM, RAG, Document AI : vision par ordinateur et analyse vidéo
Niveau 1
Répond à certains critères de performance et présente un fort potentiel sur la place de marché.
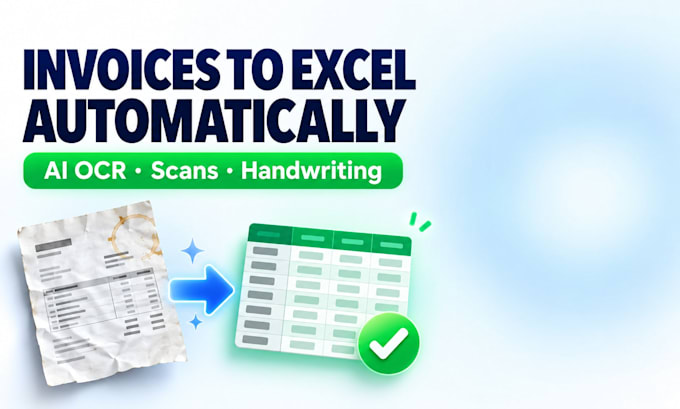
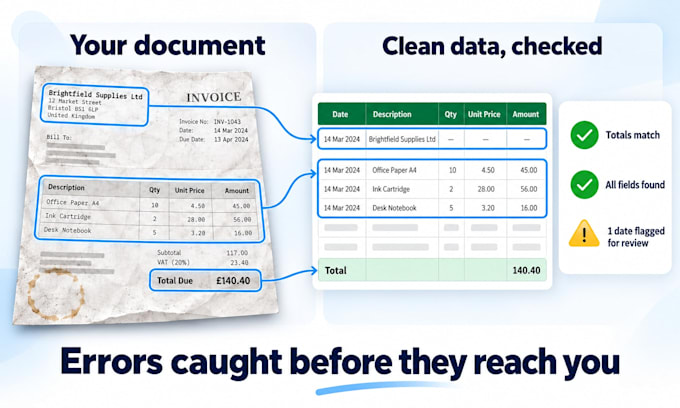
Je conçois des systèmes OCR IA qui lisent vos documents et retournent des données propres et structurées directement dans Excel, Google Sheets, votre base de données ou votre application.
CE QUE J’EXTRAIS
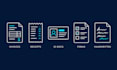
-Factures et reçus : lignes d’articles, totaux, dates, TVA, détails du fournisseur
- Relevés bancaires, bons de commande et bons de livraison
- Documents d’identité et KYC : passeports, permis, cartes d’identité nationales
- Contrats et formulaires : champs, signatures, cases à cocher
- Pages manuscrites et des pages numérisées de faible qualité
- Tables, même lorsqu’elles s’étendent sur plusieurs pages
POURQUOI C’EST DIFFÉRENT
Chaque prestation comporte des règles de validation qui détectent les erreurs avant qu’elles ne vous atteignent : totaux qui ne coïncident pas, champs manquants, dates impossibles. Vous obtenez également un rapport d’exactitude mesuré sur vos documents, et non sur une démo.
PILE TECHNOLOGIQUE : Python, PaddleOCR, Tesseract, AWS Textract, Google Document AI, Azure Document Intelligence, vision LLMs.
Vous n’êtes pas sûr que cela fonctionnera sur vos documents ?
Envoyez-moi 2 ou 3 échantillons et les champs dont vous avez besoin avant de commander. Je vous dirai honnêtement quelle précision attendre.

Technologie:
Excel
•
Google Sheets
•
Python
•
Zapier
•
Autres
Traduction automatique
Cela fonctionnera-t-il sur mes documents spécifiques ?
C’est exactement ce pour quoi sert la package preuve de concept. Envoyez 3-5 de vos documents réels et je lancerai l’extraction pour vous montrer les résultats avec un rapport de précision avant tout engagement plus important. Si vos documents ne conviennent pas, vous ne dépenserez qu’un petit montant pour le découvrir.
À quelle précision puis-je m'attendre ?
Cela dépend de vos documents, et toute personne qui vous donne un chiffre avant de les voir fait des suppositions. Les PDFs numériques propres avec des mises en page cohérentes atteignent généralement une très haute précision. Les scans de mauvaise qualité, l’écriture manuscrite et les mises en page très variables sont plus difficiles. C’est pourquoi chaque package inclut un rapport de précision mesurant cela.
Obtiens-je le code source et une API fonctionnelle ?
Oui, à partir du package Standard. Vous obtenez le code source complet, et le package Premium inclut une API ainsi que le déploiement sur votre propre serveur, conteneurisé avec Docker, et la documentation pour que votre équipe puisse le maintenir sans moi.
Mes documents sont confidentiels. Mes données sont-elles en sécurité ?
Oui, et je serai précis à ce sujet. Je n’ai besoin que d’échantillons de documents, et vous pouvez masquer les valeurs sensibles avant de les envoyer. Si vos documents ne peuvent pas être traités par un service tiers, je peux construire tout le pipeline avec OCR open-source auto-hébergé, pour que rien ne quitte votre infrastructure. T
Pouvez-vous traiter du texte manuscrit ou des scans de mauvaise qualité ?
Souvent oui, mais honnêtement cela varie plus que pour le texte imprimé. L’écriture manuscrite, les scans décolorés, les photos inclinées et les fax à basse résolution réduisent tous la précision, et l’ampleur dépend de vos documents spécifiques. La pré-traitement aide beaucoup. Envoyez des exemples de vos documents les plus difficiles dans la preuve de concept et je vous dirai ce qui est possible.
Quel format de sortie vais-je recevoir ?
Ce qui convient à votre flux de travail : JSON structuré, CSV, Excel, ou directement dans votre base de données ou application via API. Dites-moi où les données doivent finir et je vous les livrerai dans ce format plutôt que de vous donner un fichier à convertir vous-même.
Je souhaite simplement que mes PDFs soient convertis une fois, pas tout un système. Pouvez-vous faire cela ?
Oui. Le forfait Basic correspond exactement à cela : envoyez jusqu’à 50 pages d’un seul type de document et je fournis un fichier Excel, CSV ou JSON propre. Si vous souhaitez ensuite automatiser le processus, le forfait Standard transforme la même configuration en un pipeline réutilisable.