Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Pharmacien et analyste de données
Vous avez du mal à extraire des prédictions et des insights précieux de vos données complexes ? Transformons vos jeux de données bruts en modèles de machine learning puissants et prêts à la décision, qui génèrent de vrais résultats pour votre entreprise.
Je me concentre sur la résolution de vos défis spécifiques en construisant des pipelines de prédiction précis, robustes et propres en Python.
Ce que vous obtenez avec cette service :
Pourquoi travailler avec moi ?


Langage de programmation:
Python
•
Colab
•
NoSQL
Frameworks:
Scikit-learn
•
keras
•
Panda
Outils:
Jupyter Notebook
•
tensorflow
•
Excel
•
Colab
Traduction automatique
Quelles tâches de machine learning réalisez-vous ?
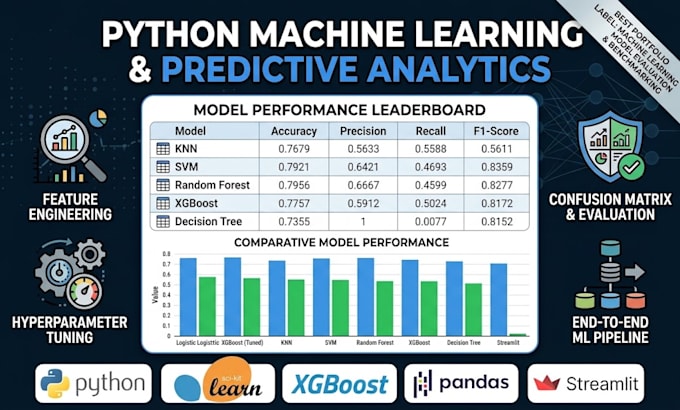
Je construis des modèles pour la classification, la régression, le clustering, l’analyse prédictive, l’ingénierie des caractéristiques, le réglage des hyperparamètres et la prédiction de churn client en utilisant Python.
Quelles bibliothèques et frameworks Python utilisez-vous ?
Je travaille principalement avec Scikit-Learn, XGBoost, LightGBM, Pandas, NumPy, Matplotlib, Seaborn et Streamlit pour les tableaux de bord web.
Recevrai-je le code source Python complet ?
Oui, vous recevrez un code Python entièrement documenté ou des notebooks Jupyter avec des commentaires étape par étape clairs.
Pouvez-vous déployer le modèle ML en tant qu’application web interactive ?
Oui ! Je peux créer et déployer un tableau de bord Streamlit interactif pour que vous puissiez tester les prédictions en direct avec des entrées personnalisées.
Quels formats de dataset acceptez-vous ?
Je travaille avec CSV, Excel, bases de données SQL et fichiers JSON.
Comment évaluez-vous la précision du modèle ?
J’évalue les modèles en utilisant des métriques standardisées comme la précision, la précision, le rappel, le F1-Score, ROC-AUC et les matrices de confusion pour garantir une performance fiable.