Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr


Traduction automatique
Vos documents contiennent les réponses, mais les trouver prend trop de temps et un chatbot générique en inventerait une.
Je crée des assistants qui ne répondent qu’à partir de vos fichiers et affichent la page exacte, la ligne ou l’URL derrière chaque réponse. Si la preuve ne se trouve pas dans vos documents, ils le disent au lieu de deviner.
Deux niveaux, un seul système.
La construction Document Q&A (Basic et Standard) est une application Python pour un petit ensemble de fichiers : PDF, CSV, TXT, Markdown ou pages web. Elle s’exécute sur votre ordinateur portable, affiche les sources sous chaque réponse et est livrée avec un guide d’installation.
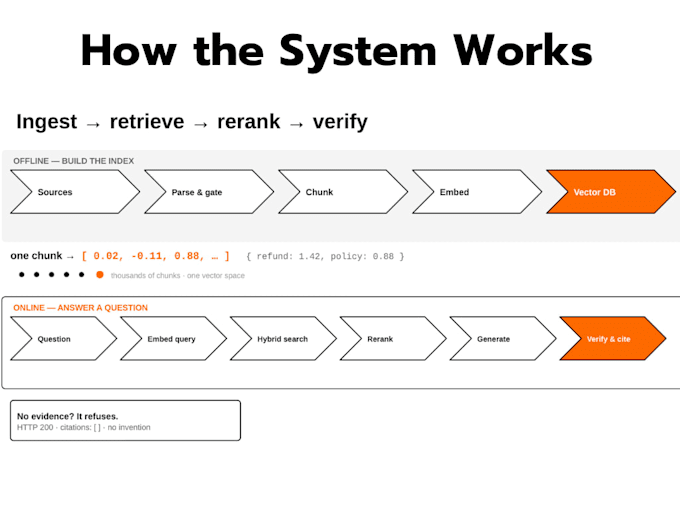
La construction ResearchOS (Premium) est destinée aux grands corpus. Recherche hybride qui combine signification et termes exacts, étape de réévaluation du LLM, découpage par phrases, une porte d’évaluation de la qualité des pages qui écarte les pages illisibles, et des citations validées avant que vous ne les voyiez. Elle s’emploie via FastAPI + PostgreSQL + Qdrant dans Docker sur votre serveur, avec une exécution d’évaluation sur vos propres documents.
Je teste tout par rapport à vos questions d’exemple avant la livraison.
Non inclus : OCR pour les PDFs numérisés, SaaS multi-locataires, entraînement de modèles personnalisé, conseils juridiques ou médicaux
AI Engineer, RAG, LLM Apps and Automation
Langues
Traduction automatique
Traduction automatique
Peut-il lire des PDFs numérisés ?
Pas d’OCR. Les pages sans couche de texte ne renvoient rien plutôt que des suppositions. Dans la version Premium, la porte de qualité les écarte explicitement et indique combien de pages ont été ignorées. Si votre numérisation est uniquement en image, dites-le moi avant la commande et je vous dirai honnêtement si cela fonctionnera.
Quelle est la différence entre Standard et Premium ?
Standard est une application locale légère pour un petit nombre de fichiers. Premium est un système déployable pour un grand corpus : recherche hybride, réévaluation, backend PostgreSQL + Qdrant, Docker et un rapport d’évaluation mesuré. Si vous n’êtes pas sûr, envoyez votre nombre de pages et je vous orienterai vers le bon niveau.
Va-t-il inventer des réponses ?
Il est conçu pour refuser. Lorsque la récupération ne trouve aucune preuve, il renvoie une liste de sources vide au lieu de générer. Dans la version Premium, les numéros de citation sont validés par rapport à ce qui a réellement été récupéré, afin que les références fabriquées soient supprimées avant que vous ne voyiez la réponse.
Quelle est sa précision ?
Je le mesure et je le rapporte. Sur un corpus de test de 296 pages : recall@10 1.00, nDCG@10 0.72, précision des citations 0.59, et chaque réponse est étayée par au moins une source. C’est une base de référence évaluée manuellement et non un benchmark — et quiconque promet une exactitude de citation à 100 % est en train de deviner.
Mes données sont-elles envoyées quelque part ?
Les embeddings et les réponses vont vers OpenAI ou Gemini en utilisant votre clé. Vos documents, extraits et vecteurs restent sur votre machine ou votre serveur — PostgreSQL et Qdrant en Premium fonctionnent localement.
Ai-je besoin d’un serveur ?
Basic et Standard : non, votre ordinateur portable. Premium : Docker avec PostgreSQL et Qdrant ; j’inclus le fichier de composition et les notes de déploiement.