Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur de données
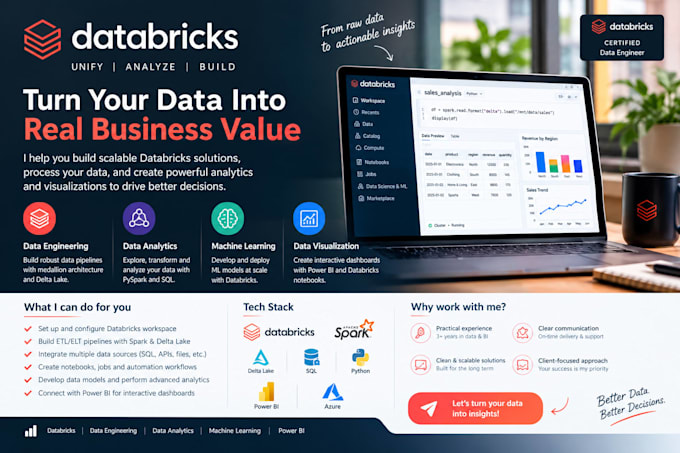
Transformez vos données brutes en pipelines de données fiables avec Databricks !
Vous cherchez de l’aide pour le traitement des données, les pipelines ETL ou la transformation de big data avec Databricks ?
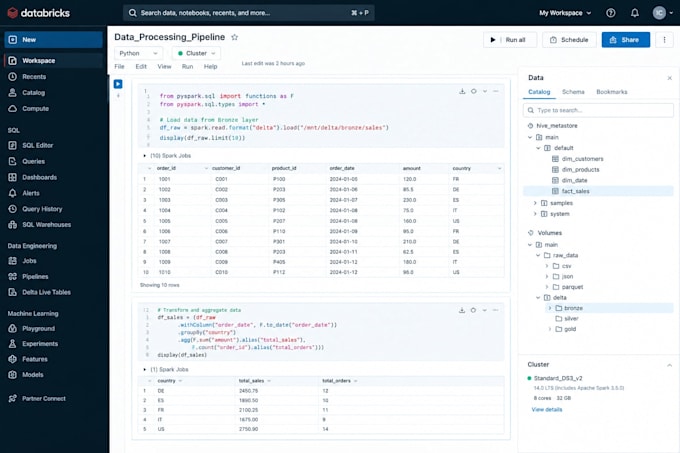
Je peux vous aider à construire, optimiser et maintenir des pipelines de données en utilisant Databricks, PySpark, Python, SQL et Delta Lake, adaptés à vos besoins spécifiques.
Fort de plus de 3 ans d’expérience en analyse de données, développement ETL, transformation de données et intelligence d’affaires, je sais comment transformer des données brutes en ensembles structurés, fiables et prêts pour l’analyse.
Mes services Databricks
1. Développement Databricks & PySpark
2. Pipelines de données ETL/ELT
3. Delta Lake & Lakehouse
4. SQL & Optimisation des données
Traduction automatique
Quelles sont vos sources et formats de données d’entrée ?
Avez-vous déjà un espace de travail Databricks ?
De quoi avez-vous besoin pour commencer ?
Veuillez fournir vos exigences de projet, des exemples de données, le résultat attendu et des détails sur votre environnement Databricks.