Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD

Traduction automatique
La plupart des problèmes de données ne sont pas des problèmes d’analyse. Ce sont des problèmes de nettoyage que personne ne veut regarder.
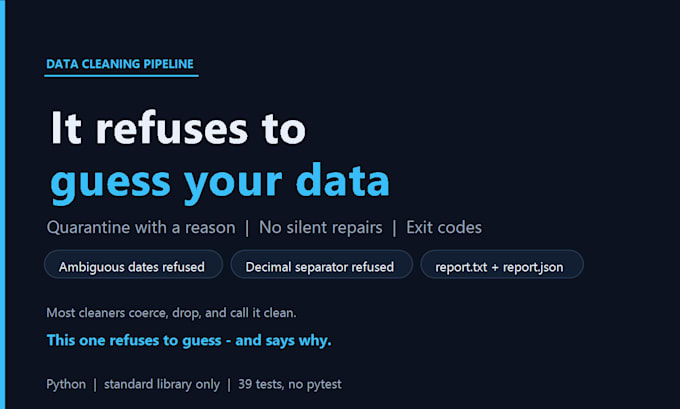
Un pipeline qui "répare" silencieusement de mauvaises données est pire que celui qui les refuse. Il transforme 15/01/2026 en le mauvais mois, supprime 3 % des lignes, et produit un rapport qui semble propre mais est incorrect.
CE QUE VOUS OBTENEZ
- Un pipeline Python qui lit vos fichiers, nettoie ce qu’il peut prouver, et met en quarantaine le reste avec une raison écrite.
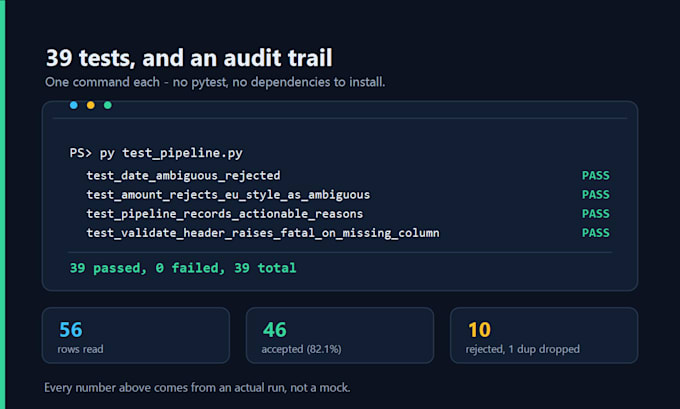
- Chaque ligne rejetée est enregistrée dans son propre fichier avec sa source et son numéro de ligne. Rien n’est supprimé discrètement.
- Des règles de validation que vous pouvez lire et modifier : types, plages, champs obligatoires, formats de date, doublons.
- Un rapport vérifiable avec des codes de sortie, pour qu’il échoue bruyamment au lieu d’écrire un fichier incorrect.
- Des tests, pour que vous puissiez modifier les règles sans les casser.
- Un document de transfert : ce qui a été construit, comment l’exécuter, ce qui a été vérifié, et ses limites.
COMMENT JE TRAVAILLE
Je regarde vos données avant de faire un devis. Si une colonne est ambiguë, je préfère demander plutôt que deviner.
STACK
Python, uniquement la bibliothèque standard. Rien à installer.
Dites-moi ce que "nettoyer" signifie pour vos données et je vous dirai si c’est adapté. Échantillons sur GitHub - contactez-moi pour le lien.
all
Langues
Traduction automatique
Traduction automatique
Quels formats de fichiers pouvez-vous gérer ?
CSV par défaut. Excel, TSV et texte à largeur fixe conviennent aussi. Votre fichier source n’est jamais modifié — le pipeline le lit et écrit de nouveaux fichiers.
Que se passe-t-il avec les lignes que vous ne pouvez pas nettoyer ?
Elles sont enregistrées dans un fichier rejeté séparé avec leur numéro de ligne source et la raison. Rien n’est supprimé discrètement, et le rapport les compte pour que vous sachiez exactement ce qui a été exclu.
Allez-vous modifier mes données originales ?
Non. Le pipeline ne lit que votre entrée. Chaque sortie est un nouveau fichier, vous pouvez donc toujours comparer le résultat à la source.
Cela peut-il fonctionner selon un calendrier ?
Oui. Il se termine avec un code non zéro en cas de problème fatal, pour que cron ou Task Scheduler puissent distinguer succès et échec sans lire le journal.
Mes colonnes ont une signification spécifique pour mon activité.
C’est précisément pour cela que je demande avant de faire un devis. Envoyez un échantillon et les règles de validation seront intégrées à vos définitions plutôt que devinées à partir des noms de colonnes.