Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Data Scientist créant des applications ML, Power BI, Statistiques, IA
Données désordonnées, dupliquées, à moitié vides ? Je vais les transformer en tableaux propres, fiables et prêts pour l’analyse.
Je suis Muhammad, data scientist et data engineer diplômé d’un MSc. Je nettoie et structure les données pour que chaque étape suivante, tableaux de bord, modèles, rapports, repose sur quelque chose de fiable.
Ce que je fais :
Formats : Excel, CSV, JSON, bases de données SQL et autres.
Pourquoi me choisir :
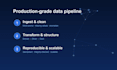
Un de mes travaux récents inclut un pipeline medallion qui a atteint 5,3x de compression avec des builds identiques byte par byte, entièrement reproductibles sur 11 tableaux prêts pour la modélisation.
Veuillez m’envoyer un message avant de commander avec un échantillon de vos données pour que je puisse confirmer le périmètre et le bon package.
Technologie:
Python
•
R
•
SQL
Traduction automatique
Dois-je vous contacter avant de commander ?
Oui, envoyez un échantillon pour que je puisse confirmer le périmètre et le package.
Obtiens-je un script réutilisable ou juste des fichiers nettoyés ?
Les packages Standard et Premium incluent des scripts documentés et réexécutables ; le package Basic fournit le fichier nettoyé et un journal.
Pouvez-vous gérer de grands ensembles de données ou du big data ?
Oui, j’utilise PySpark et Spark pour des datasets trop volumineux pour Pandas.
Le processus sera-t-il reproductible ?
Oui, chaque étape est documentée pour que vous puissiez la réexécuter sur de nouvelles données.
Mes données sont-elles confidentielles ?
Oui, et je peux signer un NDA sur demande.


