Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Extraction web (web scraping) et données produit vers Excel ou CSV
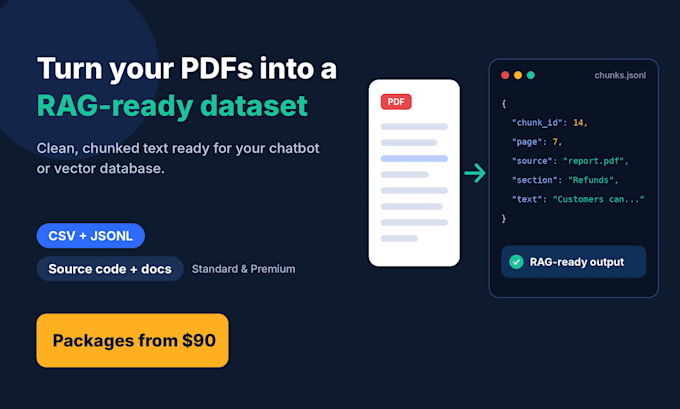
Besoin de transformer vos PDFs en un ensemble propre prêt pour le RAG ? Je génère des données structurées que vous pouvez brancher directement dans votre pipeline RAG, votre chatbot ou votre base de connaissances.
Ce que vous obtenez :
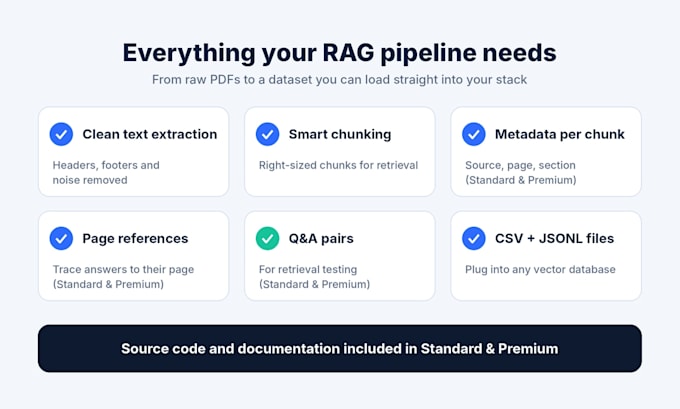
️ Extraction précise du texte (en-têtes, pieds de page et bruit supprimés)
️ Découpage intelligent avec références de page
️ Métadonnées pour chaque morceau (source, page, section)
️ Paires Q & R préétablies pour les tests de récupération et l’évaluation des LLM (Standard & Premium)
️ Ensemble JSONL + CSV, prêt pour votre pipeline RAG et votre base de données vectorielle
️ Code source et documentation (Standard & Premium)
Comment je procède : je vérifie les sorties sur plusieurs modèles et je confirme manuellement des échantillons par rapport à votre texte source pour réduire les hallucinations. Je traite vos fichiers de manière confidentielle.
Parfait pour : start-ups IA, créateurs de chatbots, chercheurs et développeurs qui construisent une base de connaissances ou un pipeline RAG.
Commencez avec l’option Basic pour tester un PDF, puis mettez en scale. Envoyez-moi un message avant la commande avec le type de PDF et le nombre de pages !

Expertise:
Autres
Frameworks:
Panda
Type de données:
Texte
Langage de programmation:
Python
•
SQL
Outils:
Excel
•
Colab
APIs:
OpenAI
Traduction automatique
Quels fichiers acceptez-vous ?
PDF uniquement. Si votre fichier est Word, PPT ou une image, envoyez-moi d’abord un message afin que je puisse confirmer s’il peut être converti.
Travaillez-vous avec des PDFs scannés ?
Les PDFs basés sur du texte fonctionnent le mieux. Les PDFs scannés nécessitent une OCR et peuvent demander un délai supplémentaire ou une offre personnalisée, merci d’envoyer un échantillon de page avant la commande.
Que vais-je recevoir ?
Chaque pack vous fournit un ensemble CSV + JSONL propre avec le texte découpé. Standard et Premium incluent également les métadonnées, les références de page, les paires Q&R, le code source et la documentation.
Mes fichiers sont-ils confidentiels ?
Oui. Je ne partage ni ne réutilise pas vos fichiers avec qui que ce soit. Si vos documents sont sensibles, dites-le avant de commander afin que je puisse vous confirmer la manière dont ils seront traités.
Combien de pages sont incluses ?
Basic : 1 PDF jusqu’à 50 pages. Standard : 5 PDFs jusqu’à 200 pages. Premium : 15 PDFs jusqu’à 600 pages. Pour plus, envoyez-moi un message pour une offre personnalisée.
Puis-je tester avec un seul PDF en premier ?
Oui, c’est exactement à quoi sert Basic. Testez un PDF, vérifiez la qualité, puis passez à Standard ou Premium.