Azure Databricks, ingénieur de données, PySpark, Azure, SQL, ETL, Oracle
Ingénieur de données avec plus de 3 ans d’expérience en informatique dans le support d’applications d’entreprise et de bases de données, spécialisé en Oracle SQL/PLSQL, traitement de données, ETL et o...
Je construis et maintiens des pipelines de données ETL/ELT en utilisant Databricks, PySpark, Python et SQL.
Je travaille avec les plateformes cloud Azure et AWS, principalement en utilisant ADLS Gen2 et Amazon S3 pour le stockage des données.
Je développe des notebooks Databricks pour extraire, transformer, nettoyer et charger des données provenant de différentes sources.
J’utilise PySpark pour traiter de grands ensembles de données et effectuer des jointures, agrégations, filtrages et transformations.
Je travaille avec Delta Lake pour créer des tables de données fiables et évolutives.
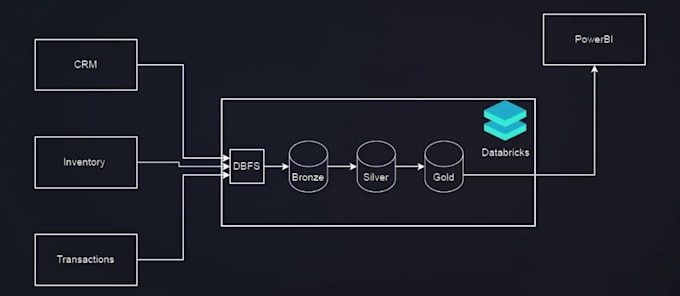
Je conçois des couches Bronze, Silver et Gold pour organiser et traiter efficacement les données.
Je connecte Databricks à des bases de données telles que Oracle, SQL Server, MySQL et PostgreSQL.
Je crée des requêtes SQL pour l’extraction, la transformation, la validation et l’analyse des données.
Je construis des pipelines de données batch et incrémentiels selon les besoins de l’entreprise.
Je planifie et automatise les pipelines en utilisant Databricks Workflows et Jobs.
J’utilise Azure Data Factory pour l’orchestration des pipelines et l’intégration avec les services Azure.
Je réalise des contrôles de qualité des données, notamment la gestion des valeurs nulles, des doublons, des données incorrectes et des changements de schéma.
Je dépanne les pipelines échoués et enquête sur les problèmes de données et de jobs Spark.
J’optimise les jobs PySpark en utilisant des techniques telles que partitionnement, mise en cache.