Parcourir les catégories
Français
$
USD
Connectez-vous à votre IA
Python et ingénierie de données, extraction web, pipelines ETL, SQL, génération vidéo par IA
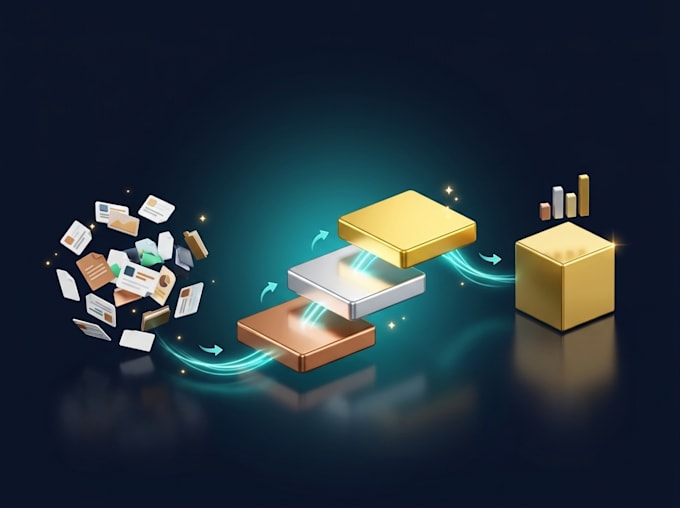
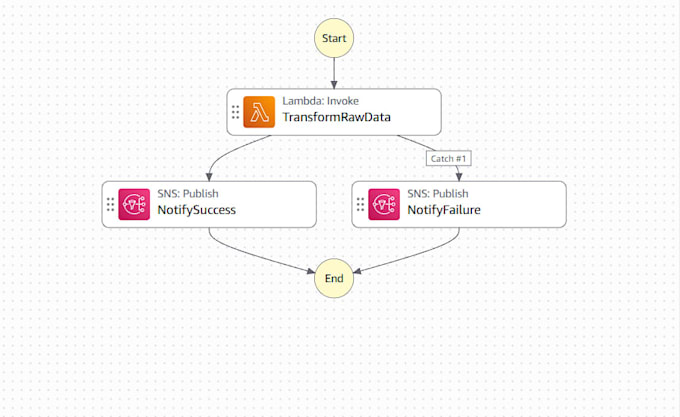
Vos données brutes bloquent dans des fichiers CSV, des API ou des tableaux désordonnés ? Je les transformerai en tables propres et prêtes à l’analyse en utilisant Databricks, PySpark et Delta Lake avec l’architecture Medallion (Bronze, Silver, Gold).
Ce que vous obtenez :
Couche Bronze : données brutes ingérées en toute sécurité, rien de perdu
Couche Silver : données nettoyées, dédupliquées et standardisées
Couche Gold : tables prêtes pour les rapports et les tableaux de bord
Notebooks PySpark et SQL bien commentés
Vérifications de qualité des données (valeurs nulles, doublons, formats erronés)
Documentation simple pour que votre équipe puisse la maintenir
Ma preuve : j’ai réalisé un projet Databricks de bout en bout qui a traité plus de 51 000 enregistrements à travers les trois couches Medallion. Je suis ingénieur de données certifié micro1 avec une formation Cloud Data Engineer (Python, SQL, AWS, Snowflake, Spark).
Note : le pipeline s’exécute dans votre espace Databricks, vous possédez donc vos données. Un compte Databricks gratuit suffit pour les petits projets.
Envoyez-moi un message avant de commander avec votre source de données et votre objectif, et je vous recommanderai le bon package.

Traduction automatique
Ai-je besoin d’un compte Databricks payant ?
Non. Un compte gratuit suffit pour les petits projets. Des charges de travail plus importantes peuvent nécessiter un espace de travail payant à votre nom.
Pouvez-vous améliorer mes notebooks existants ?
Oui. Envoyez-moi les détails et je ferai une offre personnalisée.
Vais-je comprendre comment cela fonctionne ?
Oui. Les notebooks sont commentés, et Premium comprend une visite guidée.