Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD

Traduction automatique
Vos documents détiennent déjà les réponses. Je conçois l'assistant AI qui les trouve.
Je développe des applications Retrieval-Augmented Generation (RAG) sur mesure qui vous permettent de poser des questions en anglais simple et d'obtenir des réponses basées sur vos fichiers, avec la citation exacte en source derrière chaque réponse.
Contrairement aux chatbots génériques qui inventent des faits avec assurance, mes créations sont conçues pour éviter l'hallucination : chaque réponse est extraite de vos documents, validée selon un schéma strict, et la citation de support est vérifiée automatiquement par rapport au texte source. Les affirmations non vérifiables sont signalées, pas falsifiées.
Ce que je crée
Chatbots Q&A sur PDFs, rapports, transcriptions, contrats ou une base de connaissances
Extraction structurée de champs définis dans chaque document
Synthèse interdocuments des thèmes communs et des désaccords
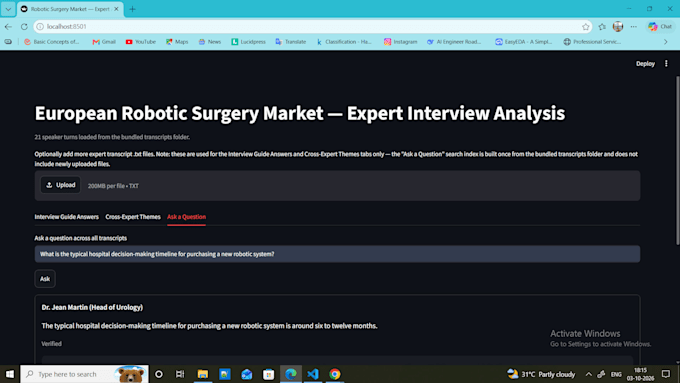
Une interface Streamlit claire que votre équipe peut réellement utiliser
Stack
LangChain, modèles Hugging Face & OpenAI, recherche vectorielle FAISS, embeddings sentence-transformer, sorties structurées Pydantic, Streamlit, Python.
Exemple de création
Voir l'élément de portfolio d'un analyseur d'interviews d'experts qui retourne des citations vérifiées avec horodatages à partir de transcriptions de recherche de marché.
Contactez-moi avec vos documents et les questions auxquelles vous souhaitez répondre
AI Engineer, LLMs, RAG, MultiAgents Systems, Python, LangGraph, LangChain
Langues
Traduction automatique
Traduction automatique
Avec quels types de documents pouvez-vous travailler ?
PDF, fichiers Word, texte brut, transcriptions, CSV, pages web scrappées. Si vous pouvez partager un exemple, je confirmerai qu'il se parse proprement avant votre commande.
Comment assurez-vous la précision des réponses ?
Chaque réponse est générée uniquement à partir de vos documents (retrieval-grounded, pas à partir de la mémoire du modèle), limitée à un schéma de données strict, et la citation de support est vérifiée par rapport au texte source avant d'être affichée. Si elle ne peut pas être vérifiée, l'application la signale au lieu de la présenter comme un fait.
Quel modèle d’IA utilisez-vous ?
Cela dépend de vos besoins. J'utilise généralement Meta Llama 3.1 via Hugging Face, et je peux utiliser OpenAI ou un modèle local open source si vous souhaitez réduire les coûts ou garantir la confidentialité totale. Nous choisirons ensemble lors du premier message.
Est-ce que j'obtiens le code source ?
Oui — chaque package inclut le code source complet et documenté ainsi qu'un guide d'installation. Aucun verrouillage.
Peut-il fonctionner en privé avec mes propres données ?
Oui. Pour les données sensibles, nous pouvons faire fonctionner un modèle open auto-hébergé pour que rien ne quitte votre environnement.
Pouvez-vous le déployer pour moi ?
Oui, en tant que fonctionnalité Premium ou option supplémentaire. Vous recevrez un lien fonctionnel et la configuration de l'hébergement.
Quelle quantité de données peut-il gérer ?
Il évolue d'une poignée de fichiers à des milliers de documents. Au-delà d'un petit corpus, je persiste l'index vectoriel sur disque pour éviter de le reconstruire à chaque exécution.
De quoi avez-vous besoin de ma part pour commencer ?
Vos documents (ou un échantillon représentatif), 3 à 5 questions d'exemple auxquelles vous souhaitez répondre, et toutes préférences de branding ou d'interface.
