Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur de données AWS, ETL, PySpark, AWS Glue, Airflow
Utilisez tout l'espace de 1200 caractères pour rendre le Gig riche en mots-clés tout en restant lisible :
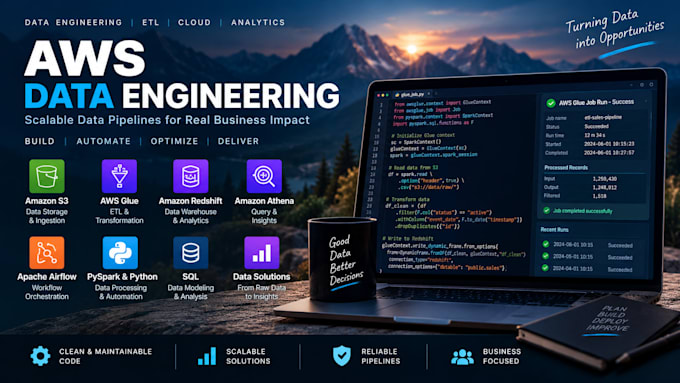
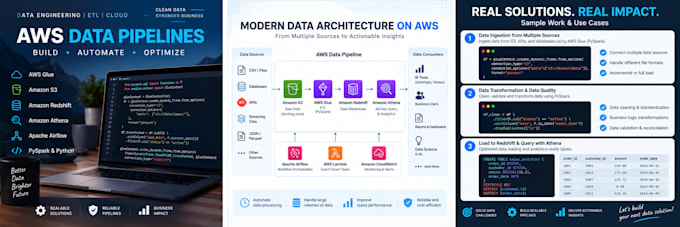
Je vais créer des pipelines de données ETL AWS fiables et évolutifs en utilisant AWS Glue, PySpark, Python, Amazon S3, Amazon Redshift et d'autres services AWS.
Je peux vous aider à développer de nouveaux pipelines de données, automatiser le traitement des données, transformer des ensembles de données ou dépanner des workflows ETL existants.
Mes services incluent :
Développement de jobs ETL avec AWS Glue
Transformations de données avec PySpark et Python
Ingestion et traitement de données S3
Traitement de données CSV, JSON et Parquet
Chargement et transformation de données Redshift
Solutions Athena et Apache Iceberg
Validation et reconciliation des données
Gestion des erreurs et journalisation des pipelines
Optimisation des performances ETL
Migration et automatisation des données
Je privilégie des solutions propres, faciles à maintenir et prêtes pour la production avec une validation, une gestion des erreurs et une documentation appropriées.
Que vous ayez besoin d'une petite tâche ETL ou d'un pipeline de données complet sur AWS, je peux développer une solution adaptée à vos besoins.
Veuillez me contacter avant de passer commande pour des besoins complexes ou multi-services afin que je comprenne votre périmètre et recommande le package approprié.
Technologie:
Amazon Redshift
•
Excel
•
Python
•
SQL
•
NoSQL
•
Apache Airflow