Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
SaaS évolutif et applications web, ingénieur senior MERN, Rails et DevOps
Vos intégrations API échouent-elles, vos tâches ETL sautent-elles des enregistrements ou vos tableaux de bord affichent-ils des données incomplètes ?
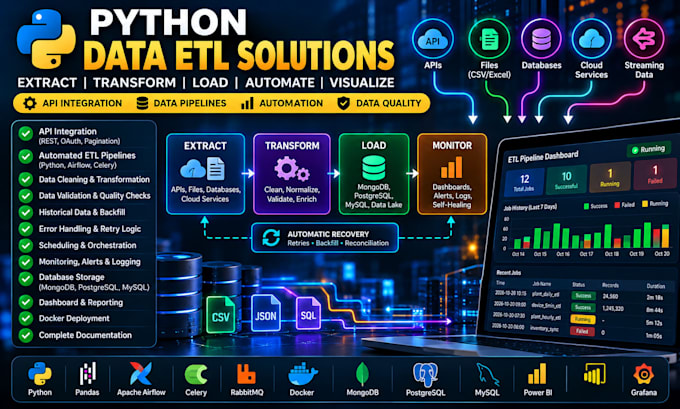
Je conçois et répare des pipelines Python ETL/ELT fiables qui déplacent des données depuis des API REST, des bases de données, des CSV/Excel et du stockage en nuage vers des jeux de données propres et utilisables.
Ce que je peux livrer :
Intégration API, pagination, OAuth et gestion des limites de débit
ETL/ELT automatisé avec Python, SQL, Pandas ou Polars
Synchronisation incrémentielle, points de contrôle, déduplication et insertions/suppressions en toute sécurité
Validation des données, contrôles de qualité et réconciliation des données
Remplissage historique, réessais et récupération en cas d’échec
Planification et files d’attente de tâches avec cron, Celery/RabbitMQ ou Airflow
Journaux structurés, alertes en cas d’échec et tableaux de bord de surveillance des pipelines
Intégration PostgreSQL, MySQL, MongoDB, BigQuery ou Snowflake
Déploiement Docker, tests Pytest et documentation claire
Idéal pour SaaS, commerce électronique, IoT, finance et pipelines de reporting.
Je me concentre sur des workflows récoverables et observables, pas sur des scripts à usage unique. Le remplissage dépend de l’historique de l’API source et des limites d’accès.
Envoyez-moi un message avec votre source, votre destination et le problème actuel avant de commander.


Outils et plateformes:
Kafka Connect
•
Autres
Traduction automatique
Pouvez-vous réparer un pipeline ETL existant ?
Oui. Je peux revoir les scripts Python ETL existants, investiguer les requêtes API échouées, identifier les erreurs de traitement des données, améliorer les opérations sur les bases de données et mettre en place des mécanismes de réessai et de récupération appropriés.
Pouvez-vous récupérer des données historiques manquantes ?
Oui, à condition que l’API source ou la base de données mette les enregistrements historiques à disposition. Je peux mettre en place des flux de remplissage automatiques qui identifient les périodes manquantes, récupèrent les enregistrements disponibles et mettent à jour votre base de données en toute sécurité.
Fournissez-vous des réessais automatiques et une récupération en cas d’échec ?
Oui. Selon vos besoins, je peux mettre en place une logique de réessai, un backoff exponentiel, un suivi persistant des tâches, des files de récupération et l’exécution des tâches via Celery et RabbitMQ.
Quelles bases de données prenez-vous en charge ?
Je peux travailler avec des bases de données telles que PostgreSQL, MongoDB et MySQL. Des intégrations vers des entrepôts cloud, notamment BigQuery et Snowflake, peuvent être discutées en fonction de vos exigences de projet.
Puis-je surveiller mes pipelines de données ?
Oui. Je peux mettre en place des journaux d’exécution, le suivi de l’état des tâches, des alertes en cas d’échec, des rapports de santé quotidiens et des interfaces de surveillance personnalisées utilisant des technologies back-end basées sur Python.
Pouvez-vous garantir qu’aucune donnée ne sera perdue ?
Aucun système ne peut garantir la disponibilité des données détenues par des prestataires externes. Toutefois, je peux mettre en place un suivi d’exécution fiable, une validation, des réessais, une réconciliation et des mécanismes de récupération pour réduire les pertes de données évitables et détecter les écarts non résolus.