Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD

Traduction automatique
Description :
Fournir une fonctionnalité LLM sans une suite d’évaluation revient à livrer à l’aveugle. Je conçois et mets en place des pipelines d’évaluation qui vous indiquent, chiffres à l’appui, si vos invites, votre modèle ou votre configuration RAG se sont réellement améliorés avant vos utilisateurs.
Ce que vous obtenez :
Veuillez me contacter avant de passer commande.
LLM AI Model Evaluation Specialist , QA automation Architect ,Eval pipelines
Langues
Traduction automatique
Traduction automatique
dois-je partager mes données de production ?
Non. Je travaille à partir d’échantillons que vous choisissez, de données synthétiques ou d’une exportation redacée. Tout reste sous votre NDA et est supprimé à la livraison.
Quels outils d’évaluation utilisez-vous ?
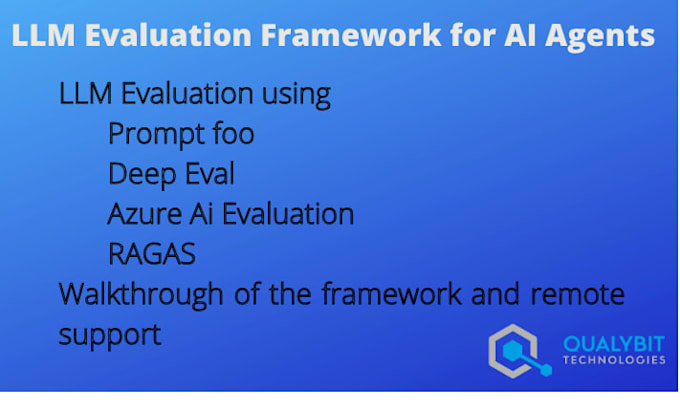
Quels outils d’évaluation utilisez-vous ? Promptfoo, LangSmith, Ragas, DeepEval, ou un harnais Python/pytest simple. Je choisis ce qui convient à votre stack ; le code vous appartient dans tous les cas.
Pouvez-vous évaluer un système RAG ou un agent, pas seulement un seul prompt ?
Oui. Pour le RAG, j’évalue séparément la récupération et la génération (précision du contexte, fidélité, pertinence de la réponse). Pour les agents, j’évalue la validité des appels d’outils et l’achèvement des tâches.
Que signifie « LLM-as-judge » et est-ce fiable ?
Un second modèle note les sorties selon une grille que je rédige avec vous. Je le calibre sur un échantillon étiqueté par un humain afin que vous sachiez à quel point faire confiance aux scores.
Effectuez-vous aussi du red-team ou des comparaisons de modèles ?
Oui — les deux sont des gigs séparés sur mon profil, ou vous pouvez les ajouter comme extras ici.