Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
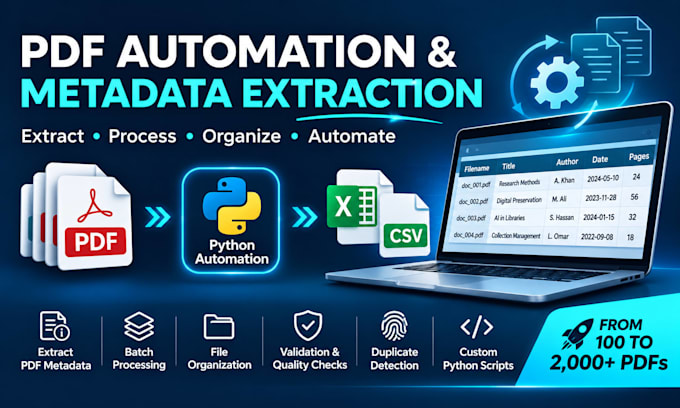
Besoin de traiter des centaines ou des milliers de fichiers PDF efficacement ?
Je développe des solutions d’automatisation en Python pour aider les entreprises, les chercheurs et les particuliers à extraire les métadonnées, organiser les documents et automatiser les tâches répétitives de traitement des PDFs.
Mes services incluent :
Pourquoi choisir mon service ?
J’ai une expérience pratique dans le développement de flux de travail de traitement de documents et de métadonnées à grande échelle. Je me concentre sur des solutions fiables et testées, avec une documentation claire.
Ce que vous recevrez :
Selon votre offre, vous recevrez des rapports de métadonnées structurés, des scripts Python réutilisables ou un flux de traitement PDF personnalisé.
Veuillez me contacter avant de commander pour discuter de vos besoins.
Note : OCR, extraction de texte de documents numérisés et mises en page complexes nécessitent un devis personnalisé.
Technologie:
Python
Expertise:
Extraction des données
•
Manipulation des données
Traduction automatique
Pouvez-vous traiter des centaines ou des milliers de fichiers PDF ?
Oui ! Je peux développer des flux de travail d’automatisation Python pour traiter de grandes collections de PDFs. Mes offres couvrent jusqu’à 100, 500 ou 2 000 fichiers, selon l’offre choisie. Des volumes plus importants peuvent nécessiter un devis personnalisé.
Quelles informations pouvez-vous extraire des fichiers PDF ?
Je peux extraire les métadonnées disponibles telles que les titres des documents, les auteurs, les dates de création et de modification, le nombre de pages, la taille des fichiers et les versions PDF. L’extraction dépend des informations intégrées dans chaque document.
Pouvez-vous extraire du texte de PDFs scannés ?
Oui, l’extraction basée sur OCR peut être discutée comme service personnalisé. Les offres standard se concentrent sur les métadonnées PDF intégrées et n’incluent pas l’OCR ni la reconnaissance de texte manuscrit.
Sous quels formats vais-je recevoir les données extraites ?
CSV est inclus dans toutes les offres. Des sorties Excel (.xlsx) ou JSON peuvent aussi être fournies sur accord avant la commande. Les scripts Python réutilisables sont inclus dans les offres Standard et Premium.
Avez-vous besoin d’accéder à mon ordinateur ou serveur ?
Aucun accès à distance n’est normalement nécessaire. Je peux développer et tester la solution à l’aide d’échantillons représentatifs. Vous pourrez ensuite exécuter le script livré sur votre ordinateur Windows ou Linux.
Comment gérer les documents confidentiels ?
Je recommande de partager des échantillons anonymisés ou non sensibles lorsque cela est possible. Je n’utilise les fichiers de projet que pour le travail convenu et ne les partage pas avec des tiers. Veuillez discuter de toute exigence particulière de confidentialité ou de gestion des données avant de commander.
Pouvez-vous créer un flux de travail personnalisé de traitement des PDF ?
Oui ! Je peux développer des flux de travail pour l’extraction des métadonnées, le renommage par lots, la détection des doublons, la validation des fichiers et la production de rapports structurés. Contactez-moi avec vos exigences afin que je puisse évaluer l’étendue et proposer un devis adapté.
