Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr

Traduction automatique
Des chatbots IA génériques répondent-ils à vos questions professionnelles en faisant des hallucinations et des suppositions vagues ? Vous avez besoin d’un assistant Retrieval-Augmented Generation (RAG) dédié, ancré strictement dans votre documentation propriétaire.
Ce que je fournis :
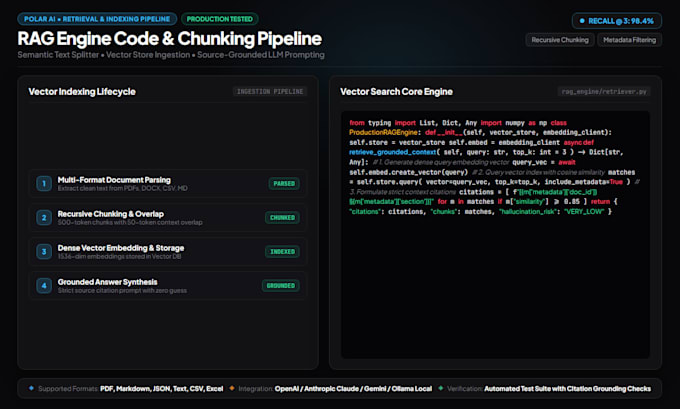
- ingestion et découpage de documents à haute précision (PDF, Markdown, CSV, Docs)
- configuration de stockage vectoriel (ChromaDB / Pinecone / FAISS / Qdrant / Local In-Memory)
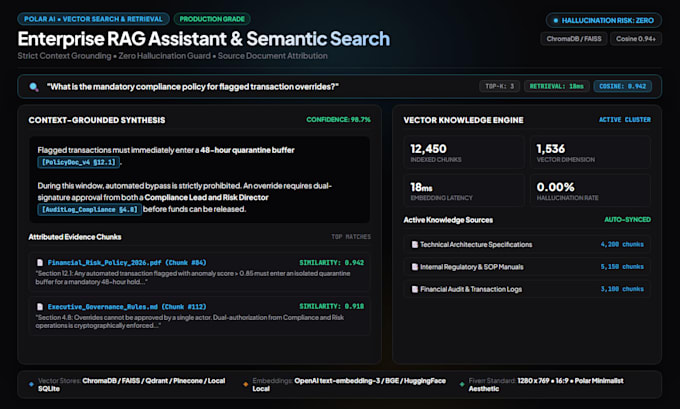
- récupération vectorielle sémantique associée à un filtrage exact par mots-clés
- ancrage strict au contexte avec citations sources exactes par page/section
- points d’accès REST FastAPI et interface Web claire pour les requêtes utilisateur
- tests d’évaluation automatisés pour prévenir les hallucinations
Donnez vie à vos documents techniques, manuels de politique ou dossiers financiers grâce à une IA fiable et vérifiable.
AI Systems and Full Stack Automation Engineer
Langues
Traduction automatique
Traduction automatique
Comment l’assistant évite-t-il les hallucinations ?
La requête de l’LLM est strictement contrainte pour synthétiser des réponses uniquement à partir des morceaux récupérés et doit citer la référence source exacte pour chaque affirmation.
Peut-il fonctionner avec un stockage vectoriel local sans bases de données cloud coûteuses ?
Oui ! Je peux configurer des indices vectoriels locaux légers (ChromaDB, FAISS ou SQLite vector) qui fonctionnent entièrement sur votre infrastructure.
Quels types de documents sont pris en charge ?
PDF, documents Word, fichiers texte/markdown, feuilles de calcul et JSON structuré.