Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Ingénieur data senior spécialisé en Cloud ETL et architecture
Vous avez besoin d’aide pour traiter de grands ensembles de données avec PySpark ou Databricks ?
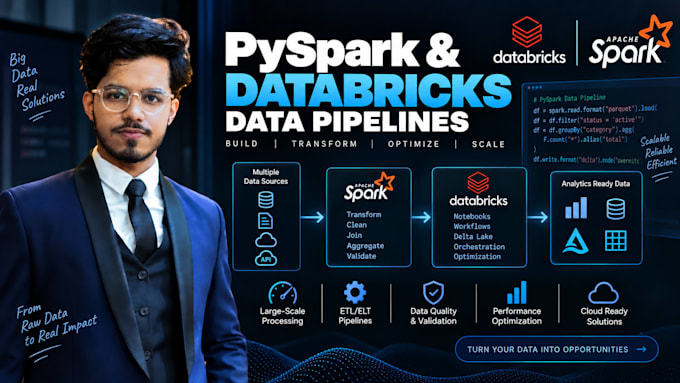
Je vais créer des pipelines de données évolutifs utilisant PySpark, Apache Spark et Databricks pour la transformation, le traitement et l’analyse des données.
Je peux vous aider avec :
Je privilégie des pipelines propres, faciles à maintenir et efficaces, avec une documentation claire.
Contactez-moi avant de commander pour des projets complexes afin que je comprenne vos données et vos besoins.
Plateforme de stockage:
Snowflake
•
Azure Synapse
•
Databricks
Type de projet:
New Build
Traduction automatique
Travaillez-vous avec Databricks ?
Oui. Je peux créer des notebooks PySpark, des transformations, des workflows ETL et des pipelines de traitement de données dans Databricks.
Pouvez-vous traiter de grands ensembles de données ?
Oui. PySpark est conçu pour le traitement distribué, et je peux construire des pipelines pour de grands ensembles de données.
Pouvez-vous optimiser un pipeline Spark existant ?
Oui. Je peux analyser les jobs lents et optimiser les transformations, jointures, partitions et charges de travail Spark.
Pouvez-vous créer des pipelines incrémentaux ?
Oui. Je peux mettre en place un traitement incrémental ou par lots selon vos besoins et les données disponibles.
Quelles sources de données pouvez-vous utiliser ?
Je peux travailler avec des fichiers, des API, des bases de données, du stockage cloud et des entrepôts de données selon le projet.
Pouvez-vous travailler avec Snowflake ou d’autres entrepôts ?
Oui. Je peux créer des pipelines qui transforment les données et les chargent dans des plateformes comme Snowflake et d’autres entrepôts supportés.
Fournissez-vous de la documentation?
Oui. La documentation est incluse selon le package choisi.
Dois-je vous contacter avant de commander ?
Oui, surtout pour des projets complexes. Merci de partager vos sources de données, transformations attendues, destination et volume de données approximatif.
