Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Ingénieur data senior spécialisé en Cloud ETL et architecture
Vous êtes toujours confronté à des rafraîchissements SQL Server lents ?
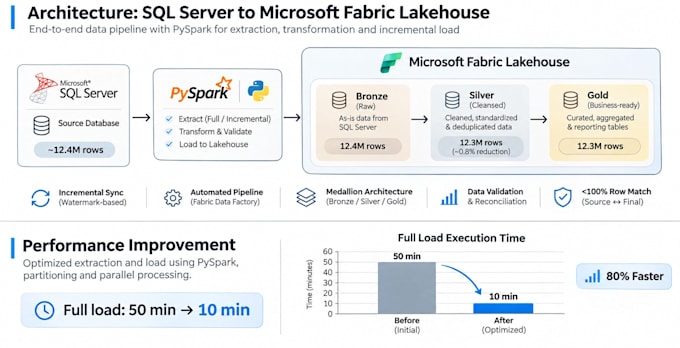
Je migrerai vos tables SQL Server vers Microsoft Fabric Delta Lake, en construisant des pipelines optimisés en charge complète et incrémentiels basés sur un watermark.
Ce que je fournis :
Mon expérience pratique : J’ai construit des pipelines Fabric avec des upserts mis en scène et un chargement incrémental, réduisant le temps d’exécution de ~50 à ~10 minutes grâce à l’optimisation.
Idéal pour les équipes modernisant des flux SQL Server et SSIS hérités.
Partagez votre schéma et vos comptes de lignes pour démarrer. Contactez-moi avant de commander pour les migrations importantes.
Type de projet:
Migration
Traduction automatique
Travaillez-vous avec SQL Server sur site ou Azure SQL ?
Les deux. Pour sur site, partagez une exportation du schéma et des lignes d’exemple. Pour Azure SQL, je peux me connecter directement. Indiquez votre version (SQL Server 2016, 2019, 2022 ou Azure SQL) lors de votre message.
Ai-je besoin d’un espace de travail Microsoft Fabric déjà créé ?
Non. Le package Premium inclut la Lakehouse et la configuration de l’espace de travail desde zéro. Pour Basic et Standard, un essai Fabric ou un espace de travail payant est nécessaire. Je peux vous guider dans la configuration en option.
Qu’est-ce qu’un pipeline incrémentiel basé sur un watermark ?
Après le chargement initial complet, le pipeline utilise un horodatage ou une colonne auto-incrément pour n’extraire que les lignes nouvelles ou modifiées et les upserter dans les tables Fabric Delta, sans rechargement complet. Vos données restent continuellement à jour.
Pouvez-vous migrer les procédures stockées et les vues ?
Les données des tables et la logique du pipeline PySpark sont incluses. La conversion des procédures stockées vers des notebooks Fabric ou des équivalents T-SQL peut être ajoutée sur demande, contactez-moi d’abord avec les détails.
Comment gérez-vous les tables de plus de 100 M de lignes ?
Je conçois en prévoyant le partitionnement, l’extraction par lots et la logique incrémentielle dès le départ. Pour les très grandes tables, le plan de migration du package Basic inclura la clé de partition et la stratégie par lots recommandées avant qu’un code ne soit écrit.
AI-je le code et puis-je le maintenir moi-même ?
Oui. Tous les notebooks PySpark, la logique du pipeline et la documentation vous appartiennent. Les versions Standard et Premium incluent des commentaires de code en ligne et un README étape par étape afin que votre équipe puisse étendre ou maintenir les pipelines de manière indépendante.