Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Projets Systems et ML C Python SQL, livrés à temps et optimisés
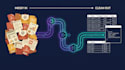
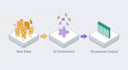
Des données enfermées dans des PDFs, des emails ou des documents que vous ne pouvez pas utiliser ? Je crée des pipelines Python alimentés par l'IA qui extraient, nettoient et structurent vos données non structurées et les livrent où vous en avez besoin.
CE QUE JE CONSTRUIS
Extraction de PDFs, emails et documents
Web scraping + sortie structurée
Classification, étiquetage et résumé par LLM
Nettoyage et déduplication des données
Fusion de sources multiples et intégration API
Planification automatisée (quotidienne, hebdomadaire, déclencheur)
Sortie vers PostgreSQL, BigQuery, Excel, Sheets, S3, Airtable
POURQUOI UTILISER L'IA DANS VOTRE PIPELINE ?
Les processus ETL traditionnels échouent avec les données non structurées. L'enrichissement par l'IA permet de :
Extraire des champs à partir de texte libre sans règles fragiles
Classer et étiqueter automatiquement les enregistrements à grande échelle
Gérer automatiquement les formats incohérents
Signaler les anomalies avant qu'elles n'atteignent votre base de données
CE QUE VOUS OBTENEZ
Code Python propre à conserver
Pipeline documenté et facile à maintenir
Sortie testée avec des données d'exemple
Support après livraison
Contactez-moi d'abord avec votre source de données, ce que vous souhaitez extraire et où doit aller la sortie.

Traduction automatique
Quels formats d’entrée supportez-vous ?
PDF, documents Word, fichiers Excel/CSV, texte brut, emails (EML/MSG), sites web, API REST, bases de données (PostgreSQL, MySQL, MongoDB) et stockage cloud (S3, Google Drive). Si votre format n'est pas listé, contactez-moi, je n'ai pas encore trouvé celui avec lequel je ne peux pas travailler.
Que signifie réellement "enrichissement par l'IA" dans une pipeline ?
Cela signifie utiliser un modèle de langage comme étape de transformation — pas comme un chatbot, mais comme un moteur d'extraction. Au lieu d'écrire manuellement des règles fragiles pour extraire un nom de fournisseur d'une facture désordonnée, le modèle lit le texte et renvoie un champ structuré propre.
Vais-je posséder le code ?
Oui, le code source complet est inclus avec chaque commande. C'est du Python propre, documenté, que vous pouvez lire, modifier et exécuter de manière indépendante après livraison, sans dépendances cachées.
La pipeline peut-elle s'exécuter automatiquement selon un planning ?
Oui — Les packages Standard et Premium incluent la planification automatisée. Je peux la configurer pour qu'elle s'exécute quotidiennement, hebdomadairement ou lors d'un déclencheur (par exemple, lorsqu'un nouveau fichier arrive dans un dossier ou qu'un webhook se déclenche). La version de base s'exécute une seule fois par défaut, mais la planification peut être ajoutée en option.
Que faire si mon volume de données est très important ?
Contactez-moi d'abord avec le volume approximatif. Pour de grands ensembles de données, je construis des pipelines avec batching, logique de retry et utilisation d'API à coût maîtrisé pour que vos coûts d'enrichissement par l'IA restent prévisibles, sans surprises sur la facture.
Ai-je besoin de ma propre clé API IA ?
Cela dépend. Pour des tâches légères, je peux utiliser des modèles open-weight sans clé requise. Pour l'enrichissement avec GPT-4 ou Claude, vous aurez besoin de votre propre clé, je vous indiquerai laquelle précisément et une estimation du coût pour votre volume avant votre commande.


