Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Besoin de pipelines de données propres et fiables sans le prix d'entreprise ?
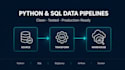
Je construis et optimise des pipelines ETL en Python et SQL pour déplacer vos données de sources désordonnées vers un entrepôt propre et prêt à interroger (BigQuery, PostgreSQL, MySQL, et plus).
Ce que vous obtenez :
SQL optimisé (fonctions de fenêtre, CTE, tuning de requêtes)
pipelines ETL en Python (Pandas, code propre et réutilisable)
orchestration Airflow (planification, retries)
contrôles de qualité des données, tests unitaires et documentation claire
Pourquoi moi : Je suis un ingénieur logiciel principal avec plus de 5 ans d’expérience dans des systèmes en production, vous obtenez des pipelines testés, documentés et faciles à maintenir à des tarifs de freelancer.
Basé en Indonésie (GMT+7). Je réponds dans les 24h et je livre selon un calendrier clair.
Contactez-moi avant de commander pour que je puisse confirmer le bon service pour votre projet.

Outils et plateformes:
Kafka Connect
•
Autres
Traduction automatique
Je ne suis pas sûr du package dont j'ai besoin — pouvez-vous m'aider ?
Absolument. Contactez-moi avec vos sources de données et ce que vous souhaitez à la fin (un rapport, une table, un pipeline planifié). Je vous dirai honnêtement quel niveau convient — ou je peux créer une offre personnalisée si c’est plus petit que Basic.
Qu'est-ce qu'un "connecteur" ?
Un connecteur est un flux de données d'une source à une destination — par exemple, tirer depuis un CSV/API/base de données et le charger dans votre entrepôt. Le ETL standard couvre une source ; le Pipeline orchestré en couvre 3 ; le Pipeline de production en couvre 5.
Quels bases de données et entrepôts supportez-vous ?
BigQuery, PostgreSQL, MySQL, Google Cloud Storage et Oracle. Vous utilisez autre chose ? Contactez-moi et je vous dirai si je peux vous aider.
Vais-je obtenir le code source — en suis-je propriétaire ?
Oui — vous en êtes propriétaire. Vous recevez un code propre, commenté, ainsi que la documentation pour le faire fonctionner et le maintenir.
Gérez-vous des données en temps réel / streaming ?
Ce service concerne les pipelines ETL batch. Le streaming est un service séparé — contactez-moi pour en discuter directement.
De quoi avez-vous besoin de ma part pour commencer ?
L’accès à (ou des échantillons de) vos sources de données, les détails de votre destination, et une description claire du résultat final souhaité. Plus vous donnez de détails dès le départ, plus la livraison sera rapide et précise.
Et si le pipeline doit être modifié après livraison ?
Chaque service inclut des révisions (1 à 3 selon le niveau) pour que ce soit parfaitement conforme au périmètre convenu.
