Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Expert en backend Python et automatisation, FastAPI, web scraping, API REST
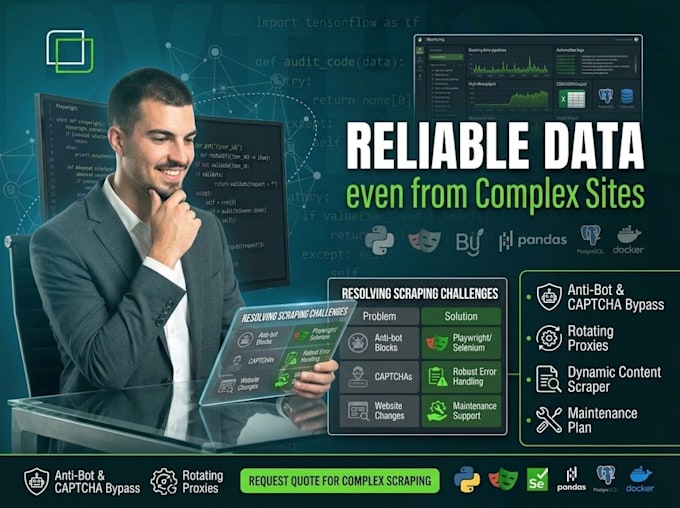
Je crée des web scrapers de niveau production qui extraient des données de manière fiable, même à partir de sites JavaScript complexes.
Ce qui me distingue :
Ce que vous obtenez :
Parfait pour :
Pile technologique :
Python Playwright BeautifulSoup Pandas APScheduler PostgreSQL Docker


Technologie:
Python
•
sélénium
•
Beautiful Soup
•
Playwright
•
Pandas
Technique:
Automatisé(e)
Traduction automatique
Quels types de sites Web pouvez-vous gratter ?
Je peux scraper la plupart des sites, y compris ceux utilisant beaucoup de JavaScript (avec Playwright), les plateformes e-commerce, les sites d’annonces et les agrégateurs de données. Je gère la pagination, le défilement infini et le contenu dynamique. Les sites avec protection anti-bot nécessitent des solutions sur mesure — contactez-moi d’abord pour évaluer la faisabilité.
Qu’est-ce qu’une "source" ou une "page" ?
Une source = un domaine/site web. Une page = une URL unique scrappée (page produit, annonce, article). La pagination sur plusieurs pages de résultats compte comme plusieurs pages. Je confirmerai la portée exacte avant de commencer pour éviter toute confusion.
Quel format de données vais-je recevoir ?
Vous choisissez : CSV, JSON, Excel (XLSX), ou livraison directe en base de données (PostgreSQL/SQLite). Les données sont correctement formatées, validées, avec les doublons supprimés et les valeurs manquantes traitées. Sortie propre et prête à l’emploi.
Fournissez-vous le code source ?
Oui, tous les packages incluent le script Python complet avec une documentation claire. Vous pouvez l’exécuter vous-même ou je peux vous aider à le planifier sur votre serveur. Le package premium inclut une assistance pour le déploiement.
Pouvez-vous scraper des sites avec login/authentification ?
Oui, je gère les flux de connexion, les cookies et la gestion des sessions. Le scraping d’authentification est inclus dans les forfaits Standard et Premium.
Le web scraping est-il légal ?
Le scraping de données accessibles au public est généralement légal, mais je respecte toujours le fichier robots.txt et les limites de taux. Je ne scrape pas de contenu protégé par des droits d’auteur, de données personnelles ou de paywalls. Vous êtes responsable de l’utilisation que vous faites des données.
Que se passe-t-il si le site change après la livraison ?
Tous les scrapers incluent des notifications d’erreur. Si la structure du site change dans les 30 jours suivant la livraison, je mettrai à jour le scraper une fois gratuitement. Après cela, les mises à jour sont disponibles en tant que révisions payantes.
Que faire si le site bloque les scrapers ou utilise des CAPTCHAs ?
J’utilise des proxies rotatifs, la rotation des user-agents, et je peux intégrer des services de résolution de CAPTCHA si nécessaire (forfait Premium). La plupart des sites peuvent être scrappés de manière éthique sans déclencher de blocages.
Mon scraper sera-t-il cassé lorsque le site change ?
Je construis des scrapers avec des sélecteurs robustes et une gestion des erreurs. Les changements mineurs du site ne le cassent généralement pas. Les refontes majeures peuvent nécessiter des mises à jour (incluses dans le plan de maintenance Premium).
Pouvez-vous livrer les données directement dans ma base de données ?
Oui ! Je peux livrer dans PostgreSQL, MySQL, MongoDB ou toute autre base de données que vous utilisez (forfaits Standard et Premium).