Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD


Traduction automatique
Vous souhaitez dynamiser votre application Ruby on Rails avec des fonctionnalités IA modernes ? Je crée des intégrations IA de niveau production, spécialement conçues pour les backends Rails. Oubliez les scripts fragiles, obtenez un code Ruby propre, facile à maintenir et qui s’intègre naturellement à votre architecture de production.
Services proposés :
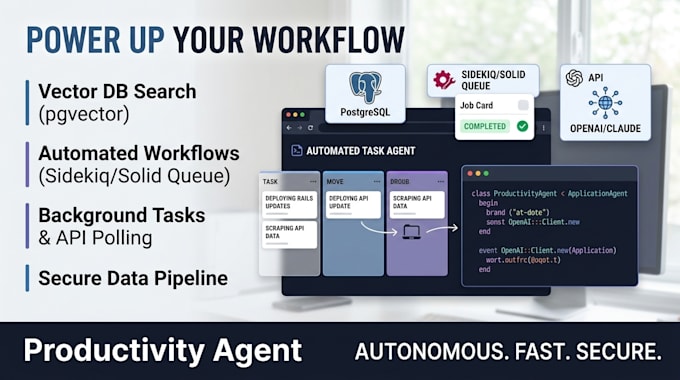
Pile technologique : Ruby on Rails (7/8), PostgreSQL, pgvector, API OpenAI, Anthropic Claude, Sidekiq, Hotwire, Tailwind CSS.
Arrêtez de lutter avec des scripts génériques qui cassent votre architecture. Construisons un système IA rapide, sécurisé et évolutif, directement intégré à votre écosystème Rails.
Veuillez m’envoyer un message avant de commander pour discuter de votre configuration technique !
AI Automation Architect Ruby on Rails LLM Integrations
Langues
Traduction automatique
Traduction automatique
Ai-je besoin d’une application Rails existante ?
Oui, ces packages s’intègrent dans des bases de code Rails actives. Contactez-moi pour des créations d’apps entièrement personnalisées !
Qui couvre les coûts de l’API LLM ?
Vous fournissez votre propre clé API. Je la configure en toute sécurité via des variables d’environnement.
Gérez-vous l’interface de streaming en direct ?
Oui, j’utilise Hotwire (Turbo Streams) pour diffuser les réponses LLM token par token.