Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur IA et Data
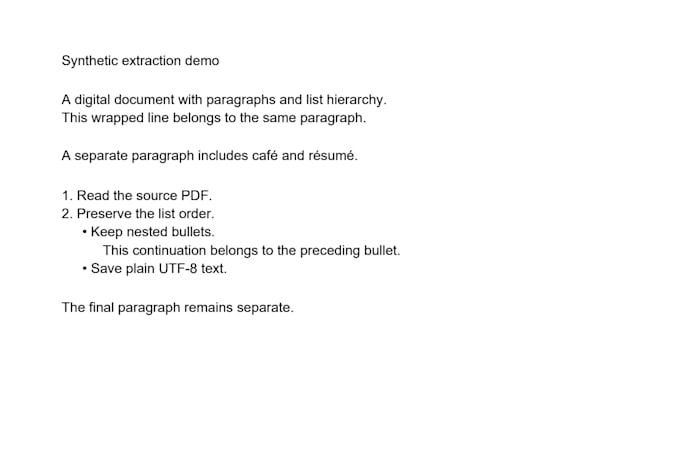
Obtenez un texte brut UTF-8 propre à partir de PDFs numériques, en conservant les paragraphes et les listes numérotées ou imbriquées.
Basique : 1 PDF, jusqu’à 10 pages, 2 jours.
Standard : jusqu’à 3 PDFs, 30 pages au total, 3 jours.
Premium : jusqu’à 5 PDFs, 50 pages au total, 3 jours.
Chaque package comprend un fichier .txt par PDF, un script d’extraction Python, une note d’utilisation et une révision pour corriger les erreurs dans les fichiers originaux fournis. La sortie est vérifiée par rapport à vos originaux.
Les fichiers doivent contenir du texte sélectionnable dans une mise en page à une seule colonne. Les scans/OCR, tableaux, colonnes multiples, formulaires, écriture manuscrite, images et reproduction de la mise en page visuelle sont exclus. Les fichiers sources ne sont pas modifiés.
Ce travail est assisté par IA utilisant Codex sous le compte de Rounak. Les échantillons sont des démonstrations synthétiques originales, et non des travaux antérieurs de clients. L’échantillon a passé six vérifications ; la précision sur des fichiers non vus n’est pas garantie. Aucune API IA payante n’est nécessaire.
Fournissez uniquement les fichiers que vous êtes autorisé à partager, sans mots de passe ni informations sensibles inutiles. En cas de doute, envoyez un échantillon non sensible avant de commander.

Convertir d'un:
Convertir en:
Autres
Traduction automatique
Pouvez-vous traiter des scans ou des tableaux ?
Ce package couvre le texte sélectionnable dans des PDFs numériques à une seule colonne. Les scans, OCR, tableaux, formulaires et colonnes multiples sont hors de son champ d’application. Envoyez un échantillon représentatif non sensible avant de commander si vous avez un doute.
Le texte sera-t-il exactement comme dans le PDF ?
La sortie est du texte brut. Les sauts de paragraphe et les listes supportées sont conservés, mais les polices, images, tableaux et la mise en page visuelle sont exclus.
Que couvre une révision ?
Correction des erreurs d’extraction dans les fichiers originaux fournis. La création de nouveaux documents, OCR ou un autre format de sortie nécessitent un scope séparément convenu.
Les échantillons proviennent-ils de clients précédents ?
Non. Ce sont des démonstrations synthétiques originales, et non des travaux payés de clients. Ce service utilise une assistance IA divulguée sous le compte de Rounak.