Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Ingénieur de données
Vous recherchez un ingénieur data Databricks expérimenté pour construire un pipeline de données fiable et scalable ? Je suis ingénieur data Databricks certifié, fort de plus de 5 ans d’expérience dans la construction de pipelines ETL à grande échelle utilisant PySpark, Spark SQL et Delta Lake pour des clients mondiaux dans les secteurs de la finance et de la santé.
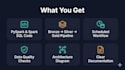
Ce que je livre :
Pourquoi travailler avec moi :
Si vous avez plus de 3 sources ou des exigences personnalisées, j’enverrai une offre sur mesure.
Traduction automatique
Quelle plateforme cloud supportez-vous ?
Je me spécialise dans Azure Databricks, y compris le stockage ADLS Gen2 et Azure Data Factory.
Et si j’ai plus de 3 sources de données ?
Contactez-moi avant de commander avec vos exigences, et je vous enverrai une offre personnalisée.
Que vais-je recevoir à la fin ?
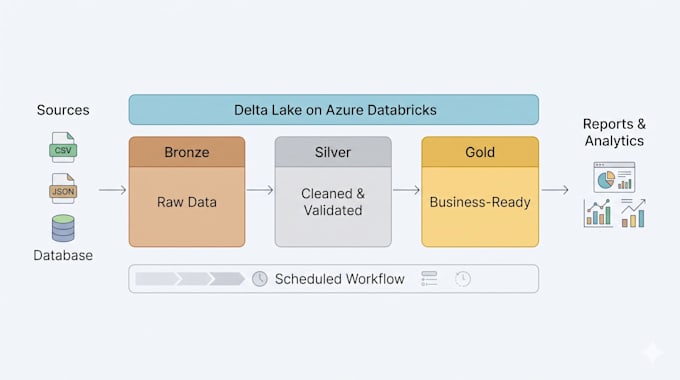
Notebooks PySpark/Spark SQL, un Databricks Workflow planifié, un diagramme d’architecture et une documentation expliquant comment exécuter et maintenir le pipeline.
Pouvez-vous travailler avec le format de données que j'utilise déjà ?
Oui. Je peux ingérer CSV, JSON, Parquet, Delta et des tables de bases de données. Partagez un échantillon avant de commander si votre format est particulier.