Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Ingénieur IA, expert en Chatbot LLM et Python Django
Python Web Scraping | Extraction de données | Automatisation web
Vous avez besoin d'une extraction de données fiable sans champs manquants, scripts cassés ou blocages IP ? Je crée des scrapers web Python performants et des workflows d'automatisation qui extraient des données structurées même à partir de sites complexes statiques et dynamiques, en gérant les mesures anti-bot, les proxies et les limites de taux en cours de route.
Ce que je peux scraper et extraire :
Livrables :
Pile technologique : Python, Selenium, Scrapy, BeautifulSoup, Playwright, Pandas
Envoyez-moi l'URL du site cible et les champs de données dont vous avez besoin. Je confirmerai la faisabilité et vous fournirai un devis précis en quelques heures.
Note : La faisabilité dépend de la structure du site et des mesures anti-scraping en place.

Technologie:
Python
•
scrapy
•
sélénium
•
Beautiful Soup
•
Pandas
Technique:
Automatisé(e)
Traduction automatique
Est-ce que cela fonctionne sur n'importe quel site web ?
La plupart des sites, oui — y compris ceux avec beaucoup de JavaScript et sites dynamiques. Certains sites avec une protection anti-bot forte (CAPTCHAs stricts, murs de connexion) peuvent nécessiter plus de temps ou ne pas être toujours possibles. Envoyez-moi d'abord l'URL et je confirmerai.
Comment gérez-vous les blocages IP ou les interdictions ?
J'utilise des proxies, la limitation des requêtes et la rotation des en-têtes/user-agent pour éviter la détection et maintenir la stabilité du scraping, surtout pour les gros ou répétés travaux.
Pouvez-vous scraper des données derrière une connexion ?
Oui, si vous fournissez des identifiants valides ou un accès, je peux automatiser les flux de connexion et scraper les données derrière ceux-ci.
Dans quel format vais-je recevoir les données ?
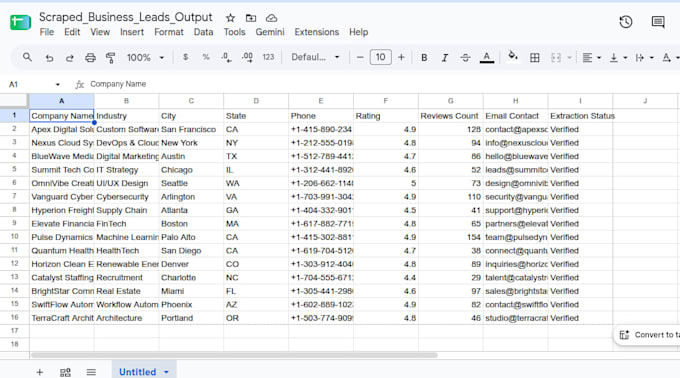
Excel (.xlsx), CSV, JSON ou synchronisé directement avec Google Sheets — selon ce qui vous convient le mieux.
Est-ce que je peux obtenir le code source du scraper ?
Oui, disponible en option supplémentaire. Je fournis un code Python propre et commenté pour que vous puissiez l'exécuter ou le modifier vous-même plus tard.
Comment gérez-vous le scraping à grande échelle (plus de 10 000 enregistrements) ?
J'utilise des requêtes asynchrones, le batching et la rotation des proxies pour scraper à grande échelle sans planter ni être bloqué, avec gestion des erreurs intégrée et réessais.
Le web scraping est-il légal ?
Je ne scrape que des données accessibles publiquement et je respecte les conditions d'utilisation de chaque site lorsque cela s'applique. Je ne contourne pas les paywalls ni n'extrais de données privées ou personnelles sans consentement.