Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Traduction automatique
Rendez les tâches routinières liées aux documents et à leurs dossiers plus faciles à répéter.
Je mettrai en place un flux de travail Python local pour extraire le texte existant des PDF numériques, inventorier un répertoire, identifier le contenu identique ou créer une copie organisée des dossiers selon des règles convenues.
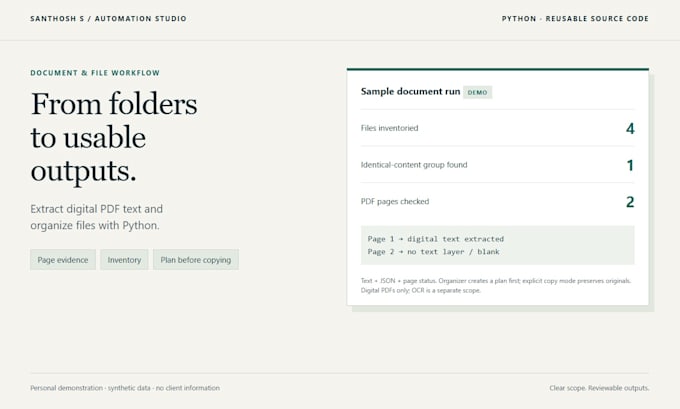
Les livrables peuvent inclure un fichier TXT par document, un JSON au niveau de la page, un CSV d’état et un inventaire avec les chemins relatifs, les tailles et les empreintes SHA-256. Les pages blanches ou celles sans contenu extractible sont signalées.
L’organisateur crée d’abord un plan révisable. Le mode copie explicite préserve les originaux et vérifie les résultats. Il ne déplace pas ni ne supprime vos documents sources.
Vous recevez du code réutilisable, les instructions d’exécution, des exemples de sorties et un résumé. Ma démonstration personnelle utilise des données synthétiques : quatre éléments inventoriés et un échantillon de deux pages vérifié, dont une page blanche.
Numérisation, OCR, écriture manuscrite, reconstruction de tableaux, documents verrouillés et web scraping nécessitent une planification séparée. L’ordre de lecture dépend de la structure d’origine.
La version Premium inclut une démonstration d’installation sous Windows et 14 jours de corrections de défauts dans le périmètre livré.
Envoyez un échantillon sanitisé, les comptes, la taille totale et votre sortie souhaitée avant de choisir un package.
Senior Executive
Langues
Traduction automatique
Traduction automatique
Pouvez-vous traiter des PDFs scannés ou des images ?
Ce package concerne les PDF numériques avec une couche de texte existante. Les scans et l'écriture manuscrite nécessitent un flux OCR planifié séparément. Les pages sans texte sont signalées plutôt qu’estimées.
Les tableaux et la mise en page originale du PDF seront-ils préservés ?
Non. Le rendu est du texte extrait avec des preuves de page. L’ordre de lecture du PDF varie, et la reconstruction des tableaux ou la préservation de la mise en page nécessite une étude séparée basée sur des échantillons.
L’organisateur va-t-il déplacer ou supprimer mes fichiers ?
Non. L’exécution par défaut produit un plan. Une exécution de copie explicite crée des copies organisées et vérifie les hachages de contenu ; les originaux sont préservés. Le contenu en double est signalé.
Puis-je relancer l’automatisation ?
Oui. Le code source Python et un guide d’exécution sont inclus. Les entrées doivent conserver la structure convenue, et chaque exécution écrit dans un nouveau dossier de sortie ou dans un dossier de sortie vide.
Quelles règles d’organisation sont incluses ?
La version Premium couvre le regroupement par extension ou par mois UTC modifié tout en conservant la structure de dossiers relative d’origine. La classification spécifique à l’entreprise ou l’extraction de champs PDF est planifiée séparément.
Quels fichiers dois-je partager ?
Envoyez d’abord un échantillon représentatif sanitisé et les comptes. Fournissez des copies PDF déverrouillées. N’envoyez pas de mots de passe ni de données personnelles inutiles. Nous confirmons le périmètre avant de traiter le lot complet.
Quelles sont les limites de fichiers, pages et tailles ?
Basique : 20 PDFs / 100 pages / 50 Mo. Standard : 100 PDFs / 500 pages / 200 Mo plus 1 000 fichiers d’inventaire. Premium : 200 PDFs / 1 000 pages / 300 Mo plus 5 000 fichiers d’inventaire et jusqu’à 2 Go de copies. Le compte PDF et les limites de pages combinées s’appliquent.
