Parcourir les catégories
Français
$
USD
Connectez-vous à votre IA
Taïwan
Spécialiste en pipeline de données avec LLM
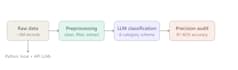
Vous avez besoin de transformer des données textuelles non structurées en catégories propres et étiquetées ? Je conçois et construis des pipelines de classification utilisant de grands modèles de langage (locaux ou via API) et Python, testés à grande échelle sur un projet traitant environ 3 millions d’enregistrements textuels.
Ce que je propose :
- Schémas de classification de texte personnalisés adaptés à vos catégories
- Étiquetage basé sur LLM (modèles locaux comme Llama, ou API comme DeepInfra/OpenAI)
- Pipelines de nettoyage et de prétraitement des données en Python
- Vérification de la précision pour que vous sachiez à quel point les résultats sont fiables
- Documentation claire de la méthodologie et des résultats
Pourquoi travailler avec moi :
Chercheur en MSc (Université Médicale de Taipei, moyenne de 4.0) avec une expérience pratique dans la construction et la validation de systèmes de classification à grande échelle. Je tiens à la précision, pas seulement à la rapidité. Chaque pipeline que je crée inclut une étape de validation pour que vous puissiez faire confiance aux résultats.
Envoyez-moi vos données et catégories, et je définirai la meilleure approche pour votre projet.