Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Passionné de recherche
Vous avez besoin d'un pipeline robuste pour l'imagerie médicale, allant des sorties brutes du scanner aux réseaux neuronaux entraînés ?
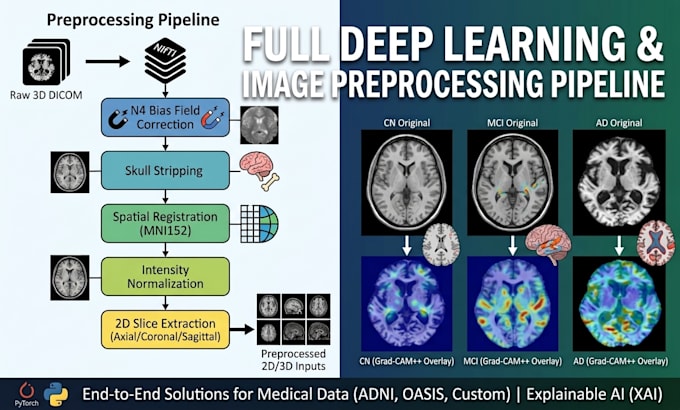
Les scans bruts (DICOM / NIfTI) ne peuvent pas être directement intégrés dans des modèles d'apprentissage profond sans un alignement spatial et une normalisation de l'intensité appropriés. Je crée des pipelines complets de vision par ordinateur médicale, gérant le prétraitement des données, la conception d'architectures personnalisées et l'interprétabilité des modèles.
1. Prétraitement des données :
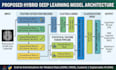
2. Apprentissage profond et classification :
3. Intelligence artificielle explicable (XAI) :
Livrables :
Veuillez me contacter avant de commander pour discuter de votre jeu de données et de vos besoins !
Traduction automatique
Quels formats d'images médicales pouvez-vous traiter ?
Je peux traiter les formats standards d'imagerie médicale brute, notamment DICOM (.dcm), NIfTI (.nii, .nii.gz), NRRD, ainsi que les formats d'images 2D (PNG, JPEG, TIFF). Que votre jeu de données soit constitué de scans volumétriques 3D ou de jeux de coupes 2D extraites, je peux créer un pipeline automatisé pour le gérer.
Votre pipeline inclut-il des étapes de prétraitement comme l'extraction du crâne ou la correction du biais ?
Oui. Les scans médicaux bruts nécessitent une standardisation avant d'être utilisés dans des modèles d'apprentissage profond. Mon workflow de prétraitement couvre la conversion DICOM en NIfTI, la réorientation spatiale (alignement RAS), la correction du champ de biais N4, l'extraction du crâne / du cerveau, l'enregistrement MNI152 et la normalisation de l'intensité.
Quels frameworks et bibliothèques d'apprentissage profond utilisez-vous ?
Je construis principalement des pipelines modulaires et reproductibles en Python en utilisant PyTorch, OpenCV, SimpleITK, NiBabel, NumPy et scikit-learn. Si vous avez besoin spécifiquement de TensorFlow ou Keras, je peux adapter l'architecture du modèle à votre framework préféré sur demande.
Comment gérez-vous le déséquilibre des classes dans les jeux de données médicaux ?
Les classes déséquilibrées (par exemple, moins d'échantillons malades que de contrôles normaux) peuvent fortement biaiser les modèles d'apprentissage profond. Je limite cet effet en utilisant des stratégies techniques telles que l'échantillonnage aléatoire pondéré lors de la création du batch, des fonctions de perte cross-entropy avec poids de classe, et des techniques d'augmentation de données.
Qu'est-ce que l'Explainable AI (Grad-CAM++) et pourquoi en ai-je besoin ?
Les réseaux neuronaux profonds sont souvent critiqués pour leur opacité. Grad-CAM++ génère des cartes thermiques d'activation de classe directement sur vos scans MRI/CT pour mettre en évidence visuellement les régions cérébrales ou anatomiques (telles que l'atrophie tissulaire ou les ventricules dilatés) qui influencent la prédiction du modèle. Cela facilite l'interprétation.
Fournissez-vous un diagnostic médical ou une évaluation clinique du patient ?
Non. En conformité totale avec les règles de Fiverr, je ne fournis pas de services de diagnostic clinique, de consultation ou de conseils médicaux. Mes services se limitent à l'ingénierie logicielle, au prétraitement des données, à l'architecture de modèles d'apprentissage machine et à l'assistance technique en recherche et développement.
Quels livrables vais-je recevoir une fois la commande terminée ?
Selon le package choisi, vous recevrez un code source Python entièrement modulaire et propre (ou Notebooks Jupyter), les fichiers de poids du modèle entraîné (.pt ou .h5), les scripts de prétraitement du dataset, des résultats d’évaluation visuelle (matrice de confusion, courbes de perte/précision, courbes ROC) et des cartes thermiques Grad-CAM++.
Pouvons-nous signer un NDA ou garantir la confidentialité de mon jeu de données de recherche propriétaire ?
Absolument. Je prends la confidentialité des données très au sérieux. Votre dataset et le code de votre projet resteront 100 % confidentiels et ne seront jamais partagés, publiés ou réutilisés sous quelque forme que ce soit. Je suis entièrement disposé à signer un accord de non-divulgation (NDA) avant que vous n’envoyiez les fichiers.