Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD


Traduction automatique
Vous cherchez un expert fiable en Machine Learning pour construire, entraîner et évaluer des modèles pour vos données ?
Je me spécialise dans le développement de solutions Machine Learning comprenant :
Que ce soit pour un projet universitaire, un article de recherche ou un jeu de données d’entreprise, je fournis des résultats propres, bien documentés et précis en utilisant Python (Scikit-learn, Pandas, NumPy, Matplotlib, Seaborn).
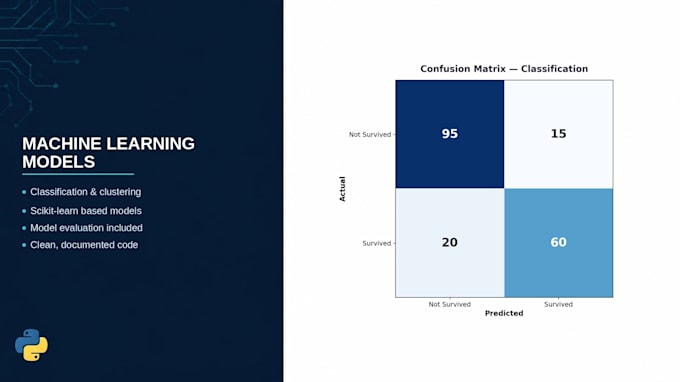
Consultez mon portfolio ci-dessous pour voir des exemples de graphiques de comparaison de précision, de matrices de confusion et de résultats de projets passés.
Pourquoi me choisir ?
Transformons vos données en insights significatifs !
Turning Raw Data Into Clear, Actionable Visuals with Python
Langues
Traduction automatique
Traduction automatique
Quels outils/langages utilisez-vous ?
J’utilise principalement Python avec des bibliothèques comme Scikit-learn, Pandas, NumPy, Matplotlib et Seaborn.
Pouvez-vous travailler avec mon propre ensemble de données ?
Oui, partagez simplement votre dataset (CSV/Excel) et je construirai le modèle en conséquence.
Vais-je obtenir le code source ?
Oui, vous recevrez le code source complet et commenté (Jupyter Notebook ou fichier .py) avec les résultats.
Expliquez-vous les résultats ?
Oui, j’explique clairement la précision, la matrice de confusion et la comparaison des modèles — idéal pour les étudiants et les présentations.
Pouvez-vous comparer plusieurs algorithmes et suggérer le meilleur ?
Absolument — comparer la précision, la précision, le rappel et le F1-score entre les modèles pour trouver le meilleur est l’un de mes services principaux.
Avez-vous des exemples de travaux que je peux voir avant de commander ?
Oui, consultez mes images/exemples dans mon portfolio sur cette page pour voir des exemples de projets passés et leurs résultats.