Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD

Traduction automatique
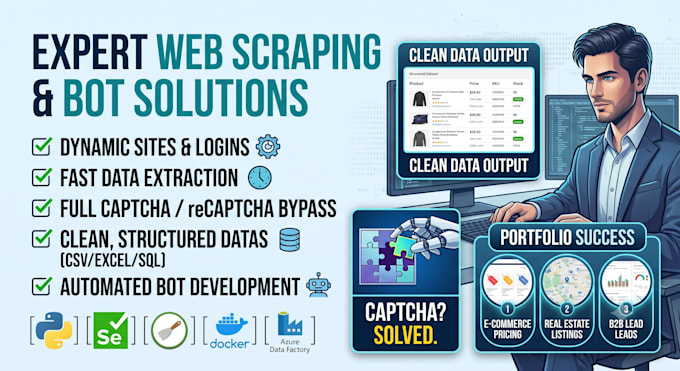
Vous avez besoin d’un bot de web scraping automatisé en Python ou d’une extraction de données à grande échelle ? Je crée des scrapers robustes, rapides et évolutifs, adaptés à vos besoins précis en données.
Fort de plus de 5 ans d’expérience en Data Engineering, j’extrais des données de pages statiques, de sites dynamiques avec JavaScript, et de portails protégés par login sans me faire bloquer.
Ce que je propose :
Technologies utilisées :
Pourquoi me choisir ?
Note : Veuillez m’envoyer le lien du site cible et les champs de données requis avant de commander, afin que je puisse tester le site et vous conseiller sur le meilleur package !
Senior Data Engineer Web Scraping ETL Pipelines Azure Microsoft Fabric
Langues
Traduction automatique
Traduction automatique
De quoi avez-vous besoin de ma part pour commencer ?
Veuillez fournir l’URL du site cible, une liste des champs/colonnes spécifiques dont vous avez besoin (par exemple, nom du produit, prix, note, URL de l’image), et votre format de sortie préféré (Excel, CSV, JSON ou SQL).
Pouvez-vous scraper des sites nécessitant une connexion ou utilisant beaucoup de JavaScript ?
Oui. Avec Selenium et Playwright, je peux gérer les formulaires de login, cookies, authentifications multi-étapes, fenêtres modales et flux à défilement infini.
Comment gérez-vous les CAPTCHA et les blocages Cloudflare ?
J’intègre des API spécialisées tierces (comme 2Captcha, CapSolver ou Anti-Captcha) avec des proxies résidentiels rotatifs et des navigateurs anti-détection comme Playwright/Undetected-Chromedriver pour contourner automatiquement reCAPTCHA, hCaptcha et Turnstile de Cloudflare.
Pouvez-vous automatiser le scraper pour qu'il s'exécute quotidiennement ou hebdomadairement ?
Oui ! Dans le package Premium, je peux containeriser le script avec Docker ou mettre en place des tâches cron ou des fonctions cloud automatisées (AWS Lambda ou Azure) pour pousser directement les nouvelles données dans Google Sheets ou votre base de données.