Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Ingénieur en données et IA
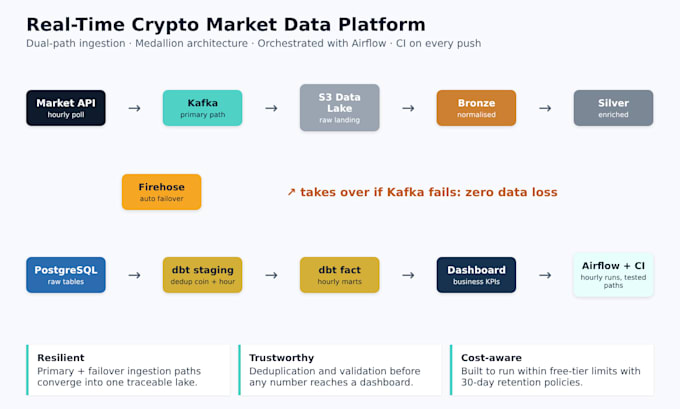
Vous avez besoin de pipelines de données fiables qui fonctionnent simplement ? Je suis un ingénieur en données avec un master en science des données et une expérience dans l'industrie chez Amazon et Tata Consultancy Services, où j'ai construit des pipelines traitant plus de 1 To de données pour plus de 100 analystes.
Ce que je peux réaliser pour vous :
Pourquoi travailler avec moi :
Comment ça fonctionne :
Vous ne savez pas quel package choisir ? Envoyez-moi un message avant de commander, je vous répondrai rapidement.

Traduction automatique
De quoi avez-vous besoin de ma part pour commencer ?
Accès ou échantillons de vos sources de données, la destination cible (base de données, entrepôt ou fichiers), et une brève description du résultat attendu. Les identifiants peuvent être partagés en toute sécurité après le début de la commande.
Avec quels outils et plateformes travaillez-vous ?
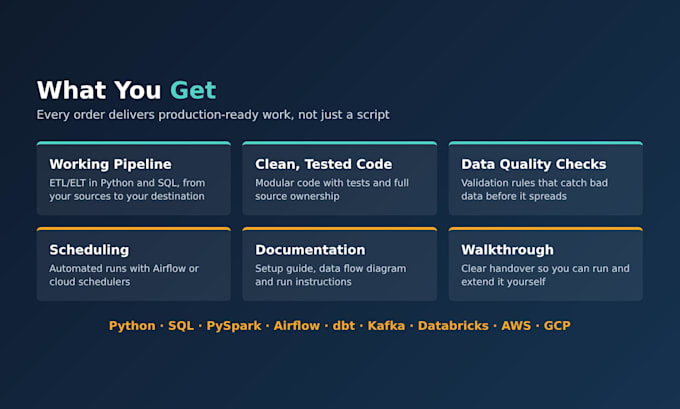
Python, SQL, PySpark, Apache Airflow, dbt, Kafka et Databricks, sur AWS, GCP ou PostgreSQL. Si vous utilisez une autre pile technologique, contactez-moi d'abord pour confirmer si je peux vous aider.
Vais-je posséder le code ?
Oui. Vous recevez le code source complet, la documentation et les instructions d'installation, et il vous appartient entièrement de l'utiliser et de le modifier.
Pouvez-vous travailler avec mon pipeline ou ma base de données existante ?
Oui. Je peux étendre, réparer ou optimiser des pipelines existants. Veuillez partager les détails avant de commander pour que je puisse définir correctement la portée.
Comment garantissez-vous la sécurité de mes données ?
Je n'utilise que les accès nécessaires pour la tâche, je ne partage ni ne stocke vos données au-delà du projet, et je peux travailler avec des données échantillons anonymisées si vous préférez.
Que faire si mon projet ne correspond pas à un package ?
Envoyez-moi un message avec vos besoins et je créerai une offre personnalisée adaptée à votre portée et à votre budget.