Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD


Traduction automatique
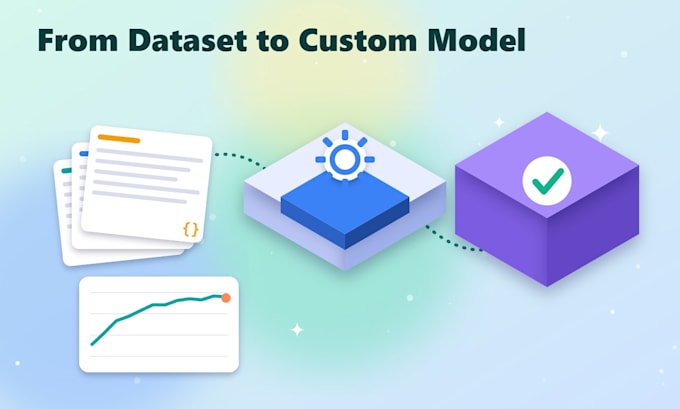
Vous avez besoin d’un LLM open-source qui connaît vraiment votre domaine, votre format ou votre style ? Je vais l’affiner sur vos données et vous montrer, avec des chiffres, à quel point il s’est amélioré.
Je suis chercheur en IA (ICML 2026, IJCNLP-AACL 2025) et j’affine et évalue des modèles open source sur des configurations multi-GPU H100 dans le cadre de mes recherches.
Ce que vous obtenez :
Modèles : Llama, Qwen, Mistral, Gemma, DeepSeek et autres modèles Hugging Face.
Envoyez-moi votre dataset et votre objectif avant de commander, je vous conseillerai le bon modèle de base, la méthode et le package.
AI Safety Researcher and LLM Fine Tuning Expert
Langues
Traduction automatique
Traduction automatique
Quel format de données avez-vous besoin ?
JSONL, CSV ou Parquet avec paires instruction et réponse (ou prompt et complétion). Si vos données sont brutes ou désordonnées, je peux vous aider à les nettoyer et à les mettre en forme d’abord.
Ai-je besoin de mes propres GPUs ?
Non. Je peux entraîner sur des GPUs cloud, avec des coûts de calcul convenus à l’avance, ou entraîner sur votre propre compte cloud ou matériel si vos données doivent rester chez vous.
De combien de données ai-je besoin ?
Pour des tâches de style ou de format, quelques centaines d’exemples de qualité peuvent suffire. Pour de nouvelles connaissances dans un domaine ou des tâches plus difficiles, quelques milliers sont préférables. Si vous en avez moins, je peux vous aider à constituer ou enrichir un dataset.
Je serai propriétaire du modèle fine-tuned ?
Oui. Vous obtenez l’adapter ou les poids fusionnés, le code d’entraînement et la configuration. Vos données et votre modèle restent privés et ne sont pas réutilisés par d’autres. L’utilisation est uniquement soumise à la licence du modèle de base.