Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr
Développeur en web scraping Python et automatisation de navigateur
Vous avez besoin de données propres et structurées extraites d’une boutique en ligne, d’un répertoire d’entreprises ou d’un site protégé par authentification sans blocs ni lignes cassées ?
Je mets en place des pipelines de scraping web Python rapides et automatisés qui livrent des ensembles de données validés et deduplicates, prêts à l’emploi.
Ce que je peux scraper et automatiser pour vous :
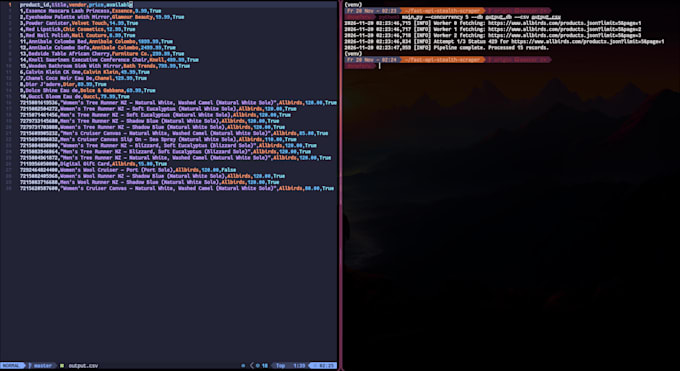
Boutiques E-commerce et Shopify / WooCommerce : titres de produits, prix, variantes, SKU, statut de stock et URL des images.
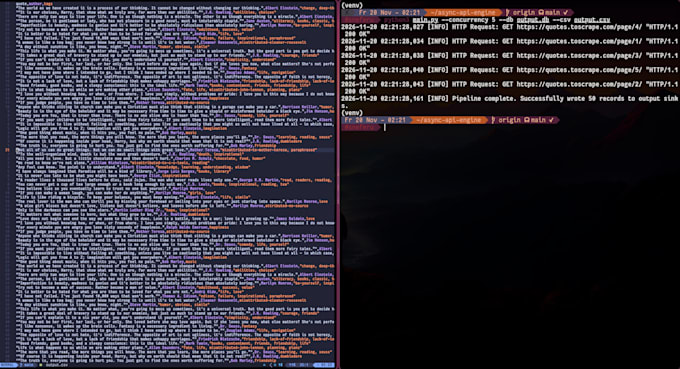
Sites dynamiques JavaScript et anti-bot : empreinte TLS furtive (curl_cffi) et automatisation du navigateur Playwright pour contourner les limites et le rendu dynamique.
Portails protégés par login : scraping automatisé de sessions authentifiées pour les tableaux de bord et les annuaires de membres.
Formats de livraison propres : CSV, Excel (.xlsx), JSON, JSONL ou bases de données SQLite — avec code source Python documenté sur les commandes Premium.
Pourquoi choisir ce service ?
Extraction asynchrone à grande vitesse (asyncio, httpx, lxml, Playwright)
Formatage des données propres, déduplication et validation des champs inclus
Prévisualisation gratuite d’un échantillon de 10 lignes avant de s’engager dans une extraction complète
Envoyez-moi votre URL cible et les champs requis avant de commander afin que je puisse confirmer la faisabilité et envoyer un échantillon !
Technologie:
JavaScript
•
Python
•
Google Sheets
•
Playwright
•
Pandas
Technique:
Automatisé(e)
Traduction automatique
Pouvez-vous m’envoyer un échantillon gratuit avant de passer une commande ?
Oui ! Envoyez-moi un message avec votre URL cible et les champs exacts dont vous avez besoin. Je scraperai un échantillon gratuit de 10 lignes en CSV ou en prévisualisation Excel afin que vous puissiez vérifier la structure et l’exactitude des données avant de commander.
Pouvez-vous scraper des sites dynamiques JavaScript ou des sites protégés par anti-bot ?
Oui. Pour les applications monopages dynamiques, la pagination ou les sites soumis à des limites de taux et à des vérifications anti-bot, j’utilise l’automatisation du navigateur Playwright et l’empreinte TLS (curl_cffi) pour extraire les données de manière fiable.
Pouvez-vous extraire des données d’un site Web qui nécessite une connexion ?
Oui, à condition que vous ayez un accès autorisé au compte. Avec le package Premium, je mets en place une automatisation Playwright persistant pour extraire des données à partir de tableaux de bord authentifiés et de portails membres.
Dans quels formats de fichiers recevrai-je mes données ?
Je peux livrer vos données propres et deduplicated au format CSV, Excel (.xlsx), JSON, JSONL, ou une base SQLite — selon le format qui convient le mieux à votre flux de travail.
Vais-je également recevoir le script scraper Python pour pouvoir l’exécuter moi-même plus tard ?
Oui ! Le code source Python propre et documenté avec les instructions d’installation est inclus dans le package Premium (ou disponible en add-on personnalisé pour les commandes Basic et Standard).