Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur en données cloud
Je vais concevoir une solution d'ingénierie des données de bout en bout pour ingérer, transformer, traiter et préparer vos données pour l'analyse.
Je me spécialise dans Azure, Azure Data Factory, Azure Databricks, PySpark, Python, SQL, ADLS Gen2 et Delta Lake.
Ce que je peux réaliser :
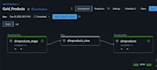
Architecture typique :
Source ADF ADLS Databricks/PySpark Delta Lake couche Gold Analyse
Que vous ayez besoin d'une nouvelle pipeline, d'une optimisation d'une pipeline existante ou d'une plateforme de données complète, je peux concevoir la solution selon vos besoins.
Vous avez un projet en tête ? Contactez-moi avant de commander pour que je comprenne vos exigences et vous recommande la meilleure solution.
Outils et plateformes:
Azure Data Factory
Traduction automatique
Avec quelles sources de données pouvez-vous travailler ?
Je peux travailler avec CSV, JSON, Excel, APIs REST et bases de données relationnelles comme SQL Server, en fonction des besoins du projet.
Pouvez-vous travailler avec des pipelines existants ?
Oui. Je peux dépanner, optimiser, modifier et étendre les pipelines de données existants en fonction de leur architecture et de leurs exigences.
Proposez-vous des solutions complètes de bout en bout ?
Oui. Pour des projets plus importants, je peux intervenir sur l'ingestion, le stockage, la transformation, la modélisation des données et les couches de données prêtes pour l’analyse.


