Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Scraping Python, automatisation des données, spécialiste des sites chinois
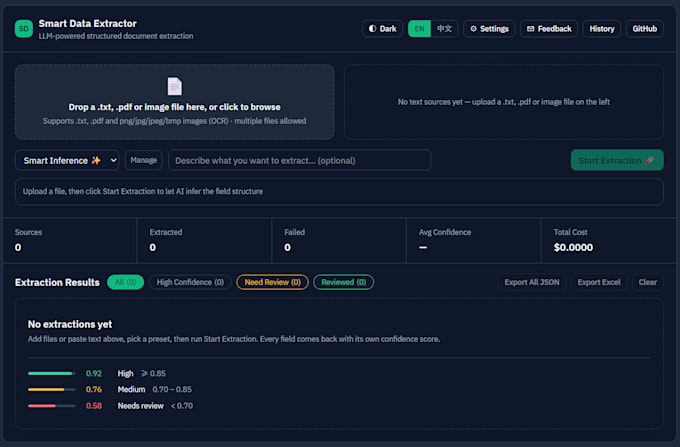
Vous avez besoin d’un outil qui transforme des PDFs, des documents scannés, des images ou du texte collé en données propres et structurées ? Je conçois des solutions d’extraction de données par IA (Python, FastAPI, React) adaptées à vos documents et à vos champs.
VOUS OBTIENEZ
- Un pipeline d’extraction utilisant un LLM et de l’OCR, adapté à votre schéma (factures, cartes de visite, leads, formulaires ou tout autre élément)
- Validation des formats pour les champs email, téléphone, URL et date
- Un score de confiance pour chaque champ. Les valeurs manquantes restent vides et signalées, jamais inventées
- Export JSON/Excel, livré sous forme de CLI, API REST ou application web selon votre package
- Code source, tests automatisés et un README
POURQUOI CETTE APPROCHE
De nombreuses démonstrations d’extraction avec LLM semblent correctes jusqu’à ce qu’elles inventent discrètement une valeur. J’applique une approche qui l’empêche : validation, signaux de confiance issus du moteur OCR et écran de révision pour les champs incertains. Je ne garantis pas une précision à 100 %, mais les champs erronés ou manquants sont signalés plutôt que laissés passer.
Ce gig repose sur un projet fonctionnel personnel, équipé de plus de 700 tests automatisés. Les documents en anglais et en chinois sont pris en charge.
AVANT DE COMMANDER
Envoyez-moi 3 à 5 documents d’exemple et les champs dont vous avez besoin, afin que je puisse confirmer la portée et le bon package.
Technologie:
Python
