Parcourir les catégories
Français
$
USD
Connectez votre assistant IA à Fiverr

Traduction automatique
Vous souhaitez automatiser des tâches répétitives de traitement de documents ?
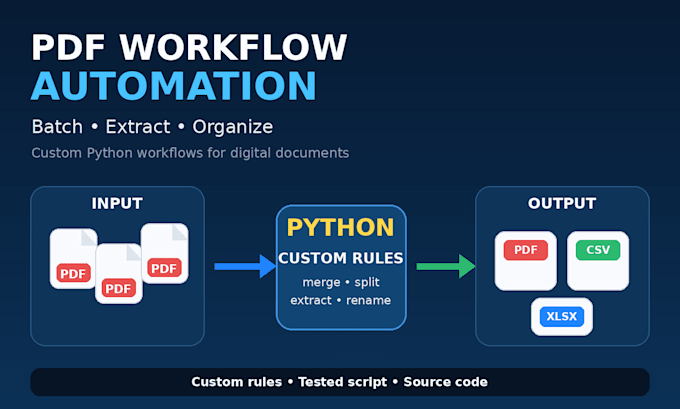
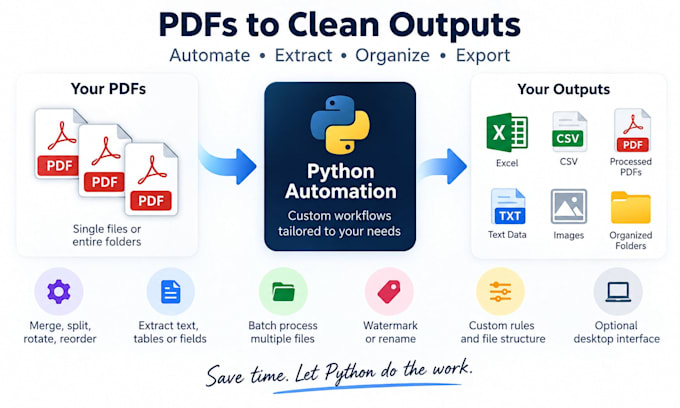
Je vais créer un workflow Python personnalisé pour des fichiers PDF numériques avec texte sélectionnable. La solution peut combiner plusieurs actions et traiter des dossiers de documents à structure similaire en utilisant des règles claires et reproductibles.
Les workflows possibles incluent :
Fusionner, diviser, faire pivoter, réorganiser, ajouter un filigrane ou renommer des fichiers
Traiter en lot des dossiers de documents
Extraire du texte, des tableaux ou des champs définis
Exporter les données extraites en CSV ou Excel
Appliquer des règles de nommage et de dossier de sortie personnalisées
Ajouter une interface desktop simple en option Gig Extra
Vous recevrez :
Le code source Python testé
Des exemples d’entrée et de sortie
Informations sur les dépendances
Instructions claires pour l’installation et l’utilisation
Les révisions sont incluses dans votre package
Veuillez me contacter avant de commander avec des fichiers représentatifs, les étapes nécessaires, le résultat attendu et votre système d’exploitation.
Les documents scannés, OCR, écriture manuscrite, déploiement sur cloud ou serveur, et les mises en page incohérentes nécessitent une revue préalable. Les fichiers protégés ou cryptés ne sont pas supportés.
Langues
Traduction automatique
Traduction automatique
Dois-je vous contacter avant de passer une commande ?
Oui. Veuillez envoyer une brève description du workflow, votre système d’exploitation et quelques fichiers d’exemple représentatifs. Je confirmerai le bon package, le prix et le délai de livraison.
Qu’est-ce qu’une opération PDF ?
Une opération correspond à une action unique comme fusionner, diviser, faire pivoter, ajouter un filigrane, renommer, réorganiser des pages ou extraire un type d’information défini.
Pouvez-vous traiter des PDFs scannés ou des images ?
Ce service concerne principalement les PDFs numériques avec texte sélectionnable. Les documents scannés, l’écriture manuscrite et l’OCR peuvent nécessiter un travail supplémentaire et doivent faire l’objet d’une offre personnalisée.
Comment s'appliquent les limites de pages du service ?
Le nombre de pages suppose des PDF numériques avec une structure cohérente. Les mises en page complexes, les pages scannées, l'OCR ou plusieurs types de documents peuvent nécessiter une offre personnalisée après examen de l’échantillon.
Vais-je recevoir le code source ?
Oui. Vous recevrez le code source Python, les dépendances nécessaires, des exemples d’entrée et de sortie, ainsi que des instructions claires d’utilisation.
Installez-vous le script sur un serveur ?
L’installation sur serveur, le déploiement cloud ou la configuration à distance ne sont pas inclus dans les packages listés. Ces services nécessitent une offre personnalisée séparée.
Qu'est-ce qui est inclus dans une révision ?
Une révision couvre les corrections dans le cadre des exigences initiales. L’ajout de nouvelles fonctionnalités, de nouveaux types de documents ou des modifications du workflow initial peuvent entraîner des frais supplémentaires.
Pouvez-vous ajouter une interface graphique simple ?
Oui. Une interface simple pour choisir des fichiers ou dossiers et lancer l’automatisation est disponible en option. Elle ne comprend pas une application desktop multi-écran complète.
Pouvez-vous extraire des tableaux ou des champs spécifiques des PDF ?
Oui, lorsque les PDF numériques contiennent du texte sélectionnable et ont une structure raisonnablement cohérente. Envoyez des échantillons représentatifs et indiquez précisément les champs ou tableaux à exporter en CSV ou Excel.