Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Traduction automatique
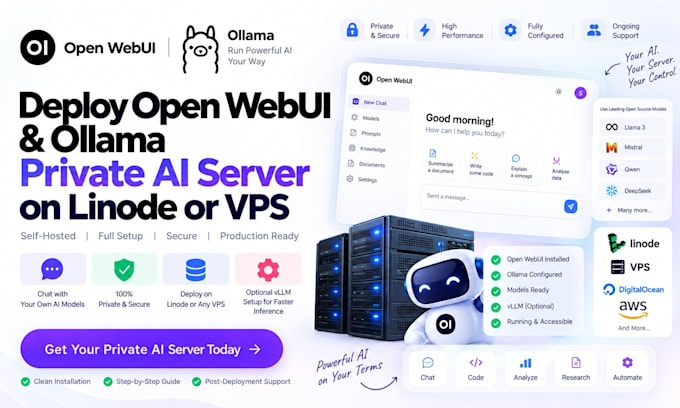
Le déploiement d'une infrastructure d'IA privée auto-hébergée nécessite un réglage précis du serveur et une intégration logicielle fiable pour assurer une inférence fluide. Je propose des configurations complètes d'Open WebUI, Ollama et de moteurs vLLM haute performance sur Linode, DigitalOcean ou tout VPS dédié, en maintenant vos données internes entièrement privées.
Ma pipeline de déploiement gère la préparation du système d'exploitation, l'accélération CUDA, l'orchestration des conteneurs via Docker, et la livraison d'une interface web sécurisée. Que vous souhaitiez des modèles locaux légers avec Ollama ou un traitement par lots continu et une faible latence alimentée par vLLM, j'optimise chaque couche selon vos spécifications matérielles.
De la configuration du chiffrement SSL du domaine à la gestion des contrôles d'accès multi-utilisateurs, vous obtenez un centre de contrôle IA clé en main, prêt pour la production, adapté aux équipes, développeurs et entreprises nécessitant un débit maximal et un contrôle total sur leurs LLM privés.
AI Server Cloud Deployment Specialist
Langues
Traduction automatique
Traduction automatique
Pourquoi devrais-je utiliser vLLM plutôt qu'Ollama standard pour servir des modèles ?
Ollama est idéal pour le développement simple sur bureau et les tâches à utilisateur unique, tandis que vLLM utilise PagedAttention et le traitement par lots continu pour offrir un débit supérieur, une faible latence et une gestion efficace de la VRAM GPU lors du service à plusieurs utilisateurs en production.
Puis-je connecter des API commerciales externes comme OpenAI ou Anthropic avec mes modèles vLLM locaux ?
Oui, Open WebUI supporte nativement les connexions doubles. Vous pouvez interroger des modèles locaux via Ollama/vLLM et des API cloud externes simultanément dans le même espace de travail utilisateur.
Quelles sont les spécifications matérielles minimales nécessaires pour faire fonctionner vLLM et Open WebUI en douceur sur un VPS ?
Alors qu'Ollama en mode CPU seul fonctionne sur des instances VPS standard, l'exécution de vLLM nécessite un VPS Linux équipé d'une GPU NVIDIA (au moins 16 Go de VRAM pour des modèles de 7B/8B paramètres) et au minimum 16 Go de RAM système pour une inférence optimale.
