Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur en apprentissage automatique
Vous avez besoin d’un modèle d’apprentissage automatique entraîné sur vos données ? Je vais construire, entraîner, tester et optimiser un modèle ML personnalisé qui fournit des prédictions précises et fiables.
Je suis ingénieur en IA (certifié Generative AI Engineer par PIAIC) avec une expérience en apprentissage automatique, apprentissage profond, vision par ordinateur, NLP et reconnaissance vocale.
CE QUE JE PEUX ENTRAÎNER :
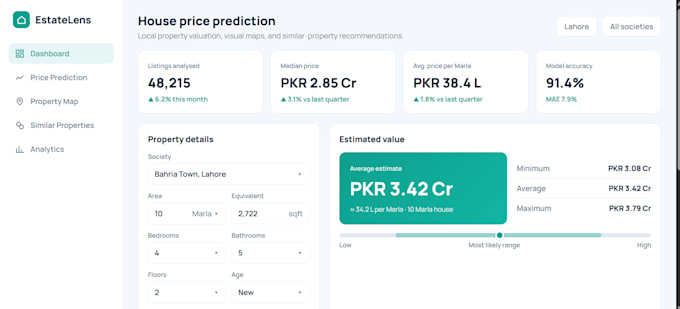
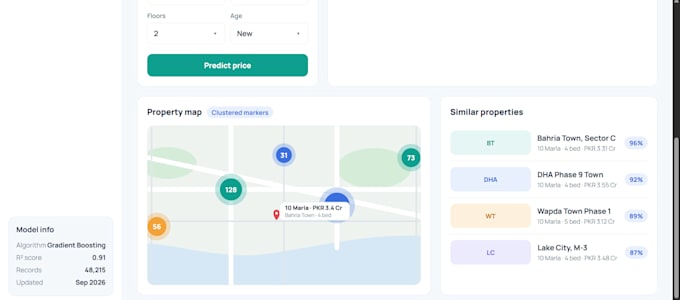
Classification et régression (churn, prix, fraude, demande)
Classification d’images et détection d’objets
NLP : analyse de sentiment et classification de texte
Modèles audio et reconnaissance vocale
Fine-tuning (PyTorch, TensorFlow, scikit-learn, Hugging Face)
CE QUE VOUS OBTENEZ :
Nettoyage et prétraitement des données
Modèle entraîné + code source Python complet
Rapport d’évaluation (précision, F1, matrice de confusion)
Documentation, API et déploiement cloud (Premium)
POURQUOI ME CHOISIR ?
- Projets complets, pas des tutoriels
- Réponses rapides et étapes claires
- Retour honnête sur la précision que vos données peuvent atteindre
Contactez-moi avant de commander avec le type de votre dataset et votre objectif, et je vous recommanderai la meilleure approche !
Langage de programmation:
Python
•
MLflow
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Panda
Outils:
Jupyter Notebook
•
opencv
•
tensorflow
•
Excel
•
MLflow
Traduction automatique
Q : Quel type de modèles ML pouvez-vous entraîner ?
J’entraîne des modèles de classification, régression, classification d’images, détection d’objets, NLP, séries temporelles et audio/vocal en utilisant scikit-learn, PyTorch, TensorFlow et Hugging Face. Envoyez-moi votre cas d’usage et je vous suggérerai la meilleure approche.
Que dois-je fournir avant de commencer ?
Votre dataset (CSV, Excel, images, audio ou texte), un objectif clair (ce que vous souhaitez prédire ou classer) et toute cible de précision ou préférence de framework. Les données étiquetées sont idéales, mais je peux aussi vous aider si vos données nécessitent nettoyage ou étiquetage.
Pouvez-vous garantir une précision spécifique ?
Aucun ingénieur honnête ne peut garantir cela, car la précision dépend de la qualité et de la taille de vos données. Je testerai plusieurs approches, optimiserai le modèle et vous fournirai un rapport d’évaluation transparent. Si votre objectif semble irréaliste, je vous le dirai dès le départ.
Que vais-je recevoir à la livraison ?
Le fichier du modèle entraîné (.pkl, .pt ou .h5), le code source Python complet, et un rapport d’évaluation avec des métriques comme la précision, F1 et la matrice de confusion. Les options Standard et Premium incluent aussi le tuning, la documentation et le déploiement optionnel.
Mes données sont-elles sûres et confidentielles ?
Oui. Vos données sont utilisées uniquement pour votre projet et ne sont jamais partagées ni réutilisées. Je peux signer un NDA sur demande, et je supprime vos données après le projet si vous me le demandez.