Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Annotation de données bengali pour la santé et l'IA
Je propose une annotation ciblée de données bengali et Banglish, une évaluation des réponses du LLM, ainsi qu'une assurance qualité pour les projets d'IA et de NLP.
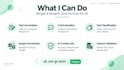
Je peux travailler avec des ensembles de données de textes bengali, Banglish et anglais, comprenant :
Annotation et étiquetage de textes bengali/Banglish
Comparaison des réponses du LLM et classement par préférence
Revue de la qualité, de la pertinence, de la fluidité et de la cohérence des réponses
Classification de l'intention, du sentiment et du texte
Normalisation et nettoyage de texte Banglish vers Bengali
Contrôle qualité du contenu bengali généré par IA
Validation et correction de datasets
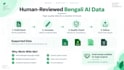
Ma méthode de travail privilégie des directives claires, un étiquetage cohérent et une dernière vérification QA avant livraison. Pour de plus grands datasets, je peux réaliser un petit échantillon initial pour que vous confirmiez les critères d'annotation avant la production complète.
Veuillez me contacter avant de commander si votre projet utilise des étiquettes personnalisées, des directives d'annotation détaillées ou une grille d’évaluation spécifique.
Technique:
Manuel
Type d'identification:
Texte
Traduction automatique
Pouvez-vous travailler avec des données bengali et Banglish ?
Oui. Je peux annoter et revoir des textes bengali, Banglish et mélangés bengali-anglais selon vos directives de projet.
Pouvez-vous suivre mes directives d'annotation ou d'évaluation LLM personnalisées ?
Oui. Envoyez votre schéma d'étiquetage, des exemples ou la grille d’évaluation. Je respecterai les critères spécifiés de manière cohérente et signalerai les cas ambigus plutôt que de deviner.
Puis-je obtenir un échantillon avant de passer une commande plus importante ?
Oui. Pour de plus grands datasets, nous pouvons commencer par un petit échantillon représentatif pour confirmer le format attendu et le standard de qualité avant de traiter l'ensemble du dataset.


