Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD
Ingénieur en apprentissage automatique
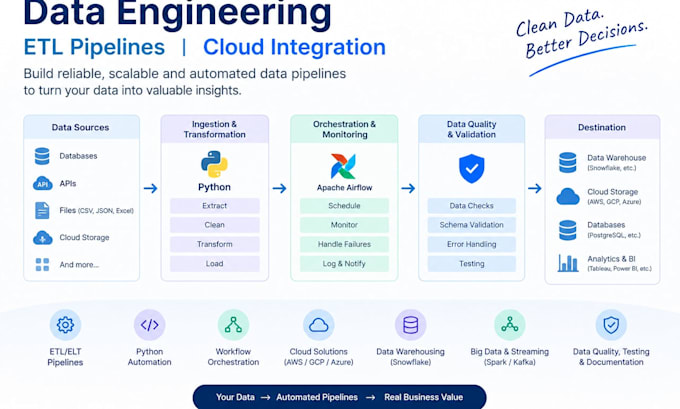
Vous avez besoin de pipelines de données fiables et évolutifs pour votre entreprise ?
Je vais concevoir des solutions d'ingénierie des données sur mesure pour automatiser les workflows, améliorer la qualité des données et simplifier le traitement des données.
Mes services incluent :
Ce que vous obtenez :
Je me concentre sur la création de solutions pratiques adaptées à vos besoins et à votre infrastructure existante.
Veuillez partager vos sources de données, le résultat attendu, le volume de données et les technologies préférées avant de commander. Les projets complexes peuvent nécessiter une offre personnalisée.
Outils et plateformes:
Autres
Traduction automatique
De quelles informations avez-vous besoin avant de démarrer un projet ?
J'ai besoin de vos exigences de projet, sources de données, résultat attendu, volume approximatif de données, fréquence de traitement et outils ou plateforme cloud préférés. Des données échantillons ou anonymisées ainsi que le code existant sont utiles si applicable.
Quelles technologies et plateformes supportez-vous ?
Je travaille avec Python, SQL, workflows ETL/ELT, Apache Airflow et des orchestrateurs similaires, Apache Spark, Kafka, Snowflake, Databricks, et des plateformes cloud telles qu'AWS, Google Cloud et Azure. La stack technologique exacte dépend de la portée du projet.
Pouvez-vous travailler avec ma pipeline de données ou mon code existant ?
Oui. Je peux aider à dépanner, modifier, optimiser ou étendre une pipeline existante. Veuillez partager l'architecture actuelle, le code pertinent, les détails des erreurs et le résultat souhaité afin que je puisse évaluer la portée avant de commencer le travail.
Vos packages incluent-ils le déploiement cloud ?
Le déploiement cloud est inclus uniquement si cela est explicitement spécifié dans le package choisi ou acheté en option. Les frais d'utilisation du cloud, abonnements tiers et coûts d'infrastructure supplémentaires ne sont pas inclus dans le prix de mon service.
Pouvez-vous construire des pipelines de streaming de données en temps réel ?
Oui, pour des cas d'utilisation clairement définis. Les intégrations en streaming peuvent être incluses dans le package applicable ou achetées en option. Les clusters Kafka complexes, les systèmes à haut débit et la configuration d'infrastructure étendue peuvent nécessiter une offre personnalisée.
Que faire si mon projet nécessite plus de travail que ce que le package inclut ?
Je vais examiner vos exigences et clarifier la portée avant de commencer. Si votre projet nécessite des sources de données supplémentaires, des transformations complexes, des intégrations supplémentaires ou une infrastructure au-delà du package choisi, je peux proposer une offre personnalisée avec un prix et un délai de livraison convenus.
