Parcourir les catégories
Explorer
Fiverr Pro
Français
$
USD

Traduction automatique
Votre modèle se charge mais ne renvoie rien. Ou il tourne à 2 tokens par seconde sur un GPU qui devrait en faire quarante. Ou il dépasse la mémoire lors d’un modèle qui devrait tenir. Je règle précisément cela.
Je gère une stack AI locale complète sur un seul 3090 — Ollama, ComfyUI, formation LoRA, modèles vocaux, pipelines automatisés. J’ai rencontré chacun de ces échecs sur mon propre matériel et j’ai compris pourquoi.
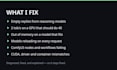
Ce que je répare :
Contactez-moi d’abord avec ce qui se passe, votre OS, GPU et VRAM. Je vous dirai honnêtement si je peux le réparer avant que vous passiez commande. Si je ne peux pas, je vous le dirai plutôt que de prendre votre argent.
Je crée et vends mes propres outils AI locaux, donc ce n’est pas de la théorie.
AI Automation and LLM Integration Developer
Langues
Traduction automatique
Traduction automatique
Pouvez-vous réparer cela si je suis sous Windows et pas Linux ?
Oui. La plupart de ces échecs sont les mêmes sur les deux systèmes — budgets de tokens, marge de VRAM, keep-alive et taille du contexte ne concernent pas votre OS. Quelques éléments diffèrent (drivers, WSL, où Ollama stocke les modèles) et je vous dirai lesquels s’appliquent à vous.
Avez-vous besoin d’un accès à distance à ma machine ?
Non, et je préfère ne pas. Pour la plupart des problèmes, je travaille à partir de vos logs, votre configuration et le résultat de quelques commandes en lecture seule que je vous fournirai, puis j’envoie la réparation avec une explication. Si vous préférez le faire en direct, un partage d’écran fonctionne, mais c’est votre choix, pas une obligation.
Et si je ne peux pas le réparer ?
Je vous le dis alors. Contactez-moi avant de commander avec ce qui se passe et votre matériel, et je vous dirai honnêtement si je peux le résoudre. Je préfère refuser une commande plutôt que de prendre de l’argent pour un problème que je ne peux pas réparer.
Mon GPU est petit ou je n’utilise que le CPU. Est-ce hopeless ?
Non, mais la réponse honnête peut être que le modèle que vous essayez de faire tourner ne tient pas. Une partie de ce que je fais, c’est vous dire ce qui fonctionnera réellement avec votre matériel, plutôt que de vous faire lutter contre un modèle qui n’aurait jamais dû fonctionner.
Vais-je juste recevoir un script, ou vais-je comprendre ce qui a mal tourné ?
Vous le comprendrez. Chaque réparation explique ce qui n’allait pas et pourquoi, car le même type de problème revient et je préfère que vous le reconnaissiez la prochaine fois plutôt que de devoir commander à nouveau.


